AWS 用 Strands Agents 搭建自适应智能体框架 AAIF
Adaptive agentic intelligence framework using Strands Agents
AWS 发布教程,介绍用 Strands Agents 构建自适应智能体智能框架 AAIF,由 llama3.2:1b 小模型做编排器,把常规请求路由到 Ollama 本地模型处理,复杂分析交给 Amazon Bedrock 云端模型。
原文给出可复用的三层路由架构与完整代码,读者可据此把常规请求留在本地小模型、复杂请求交给云端。
构建 AI 智能体的组织面临一个共同挑战:每个请求,无论是常规状态检查还是复杂分析,通常都会被路由到单个大型、昂贵的模型。这种一刀切的方法会推高 API 成本、引入不可预测的延迟,并消除离线运行的可能性。即使是可以在本地解决的常规查询,最终也需要经过完整的网络往返,才能到达云端托管的大语言模型(LLM)。
使用 Strands Agents 构建的自适应智能体智能框架(AAIF)采用了不同的方法。AAIF 不是将所有请求路由到单个大型模型,而是使用小型语言模型(SLM)在本地处理常规任务。更复杂的请求则通过 Amazon Bedrock 路由到云端托管的模型。这种方法建立在 NVIDIA 的 Belcak 等人的研究立场之上。他们认为,小型语言模型“对于智能体系统中的许多调用而言,足够强大、本质上更合适,并且必然更经济”。该框架基于 Strands Agents 构建,展示了智能模型编排如何帮助降低成本,同时为本地操作保持低延迟。
在本文中,我们将介绍 AAIF 的关键组件,使用 Strands Agents,通过 Ollama 使用本地 SLM,并通过 Amazon Bedrock 使用云端模型。我们使用物联网(IoT)监控场景作为参考实现。
解决方案概述
如图 1 所示,AAIF 将 AI 处理组织为三个层,每一层针对不同的任务类型进行优化:
- 智能编排使用轻量级 SLM(llama3.2:1b)作为决策层。该编排器对传入请求进行分类,并将其路由到适当的处理层,而无需硬编码规则。
- 本地处理通过 Ollama 在本地硬件上运行的 SLM 处理常规任务,如设备遥测数据检索和图像分析。这些任务以低延迟完成,且不依赖云端。
- 云端处理通过 Amazon Bedrock 中的前沿模型处理复杂的模式分析和战略建议。这些请求需要更广泛的上下文和多步推理,而 SLM 无法可靠地提供这些能力。
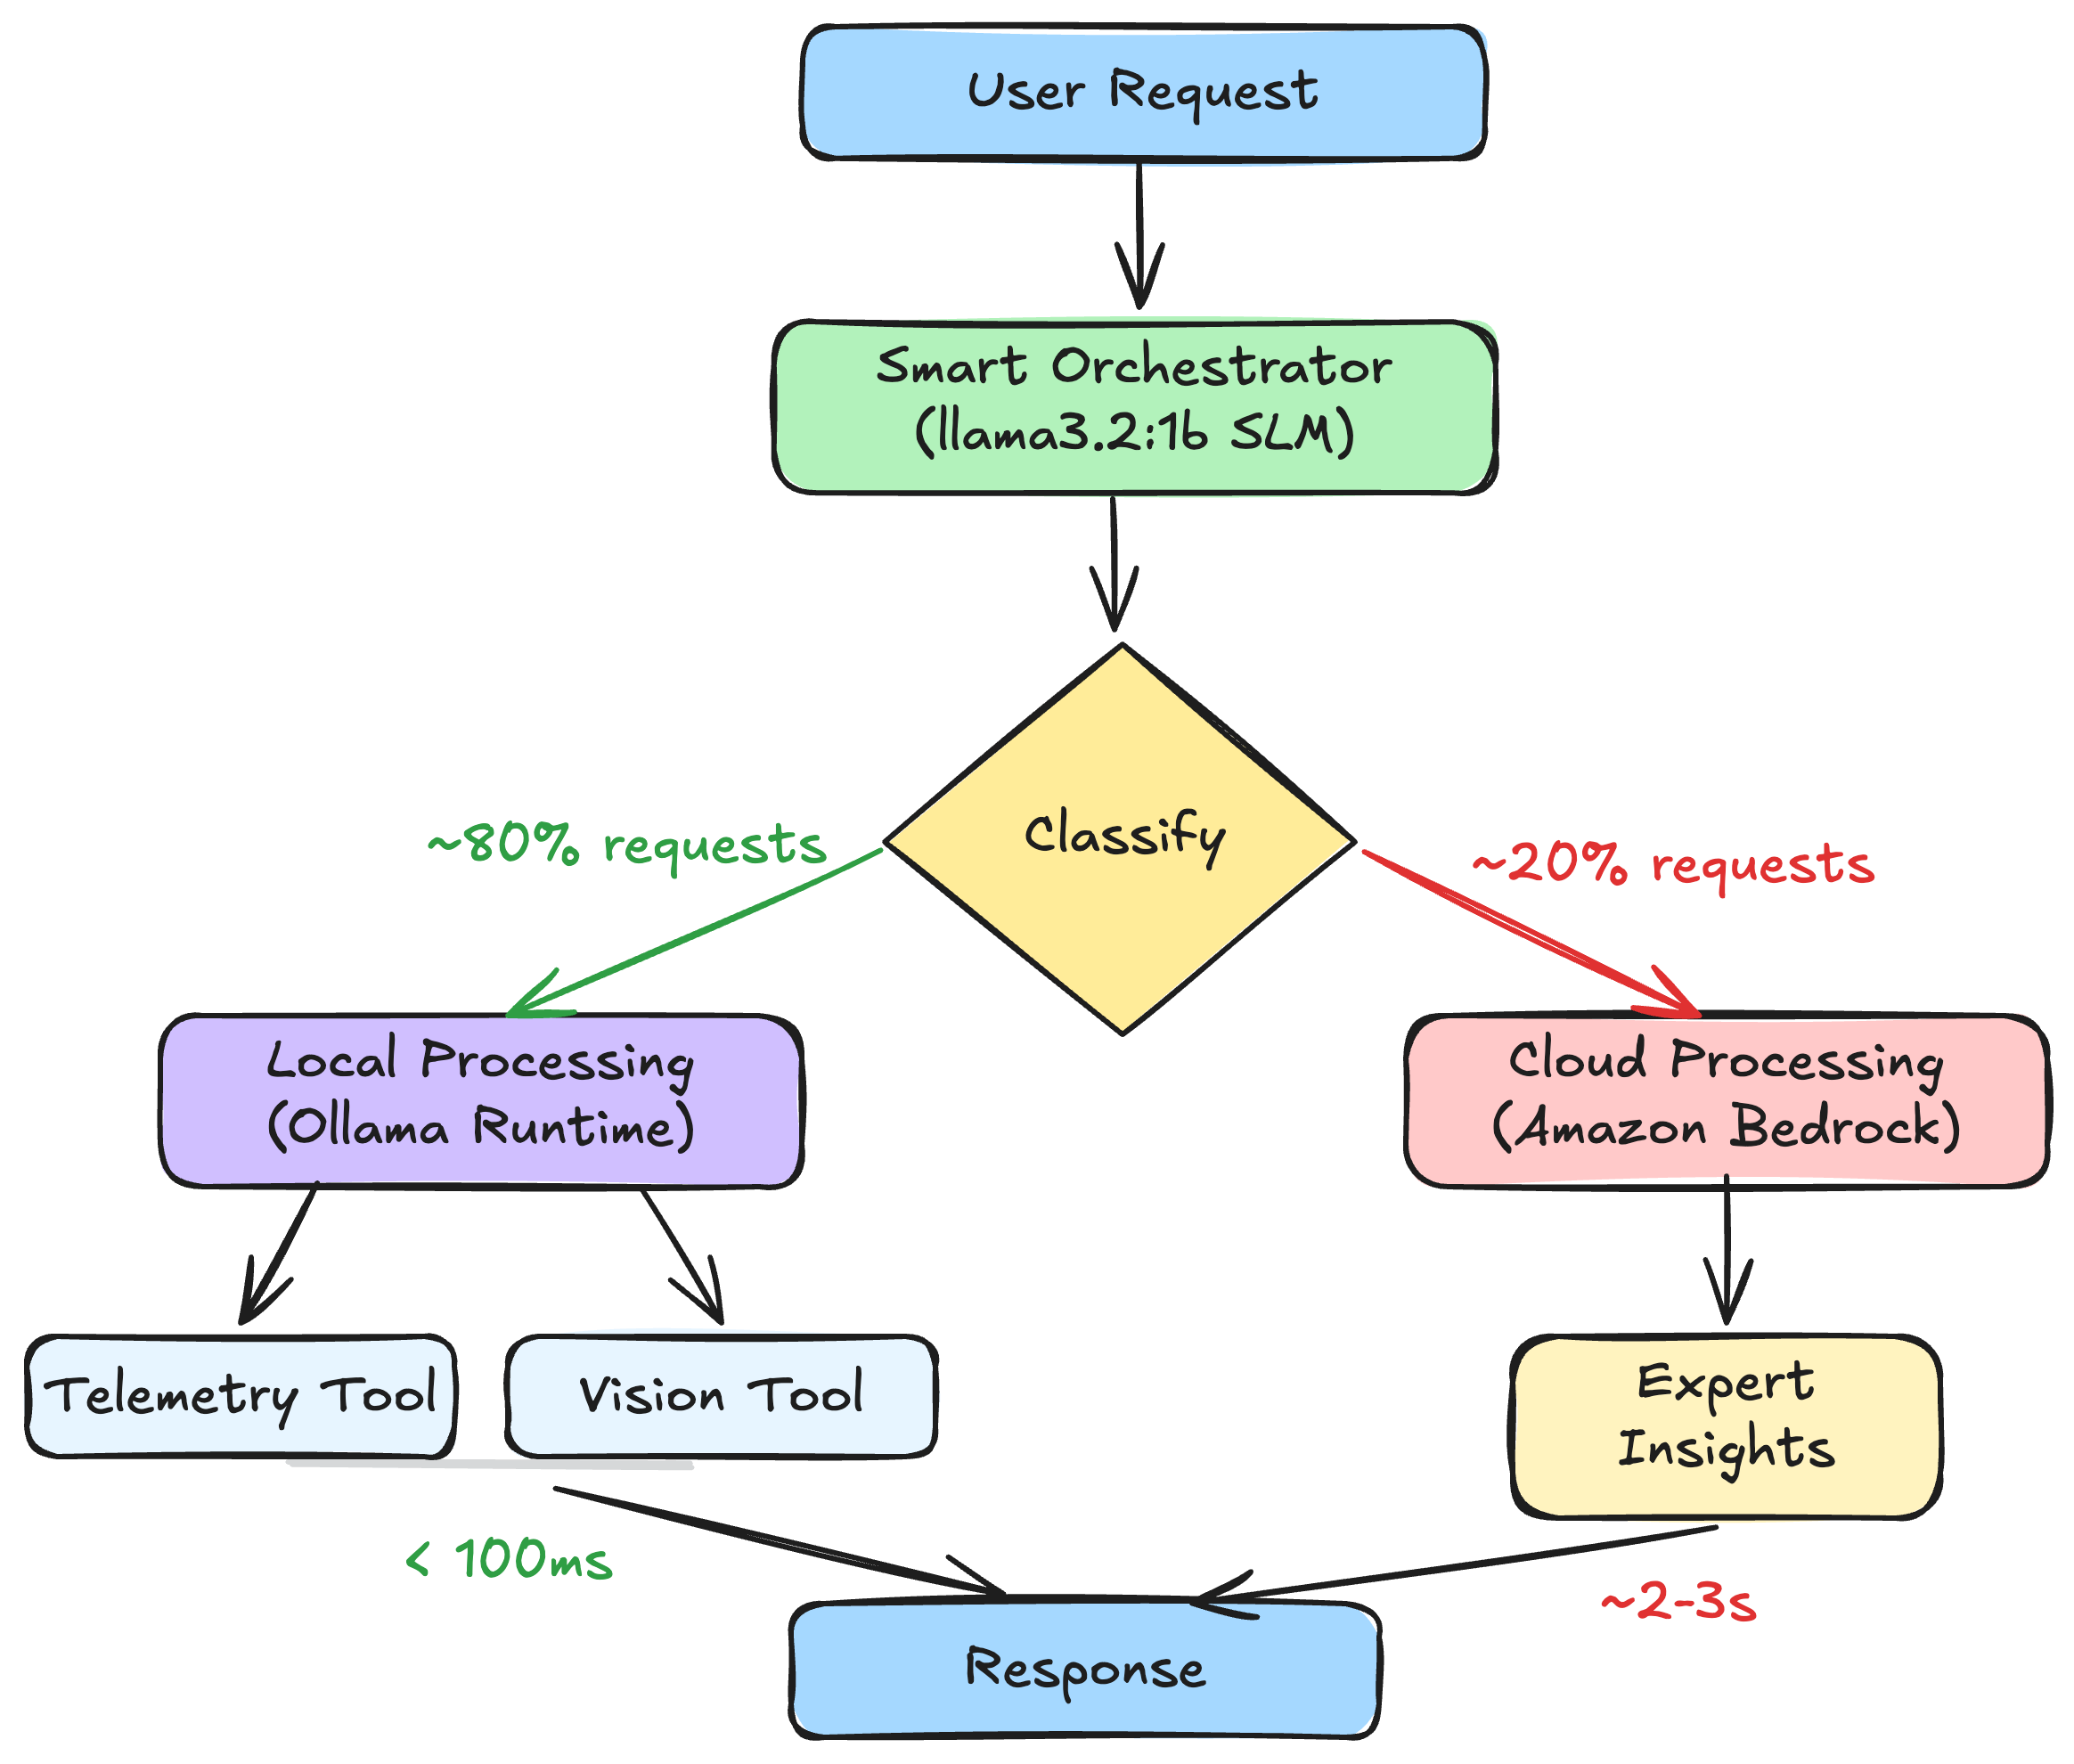
图 1:AAIF 的三个处理层:智能编排、本地处理和云端处理
图 1 展示了完整的 AAIF 系统架构。中心是 Strands 智能体,它连接到 Ollama 运行时,该运行时同时托管 10 亿参数的编排器模型和视觉模型。该智能体暴露三个工具:get_device_telemetry 用于本地传感器数据检索,analyze_camera_feed 用于通过 llama3.2-vision 进行设备端视觉处理,get_expert_insights 则通过 boto3 调用 Amazon Bedrock 进行复杂分析。传入的用户请求流经 SLM 编排器,该编排器对每个请求进行分类,并根据任务复杂度将其分派到本地工具或云端端点。
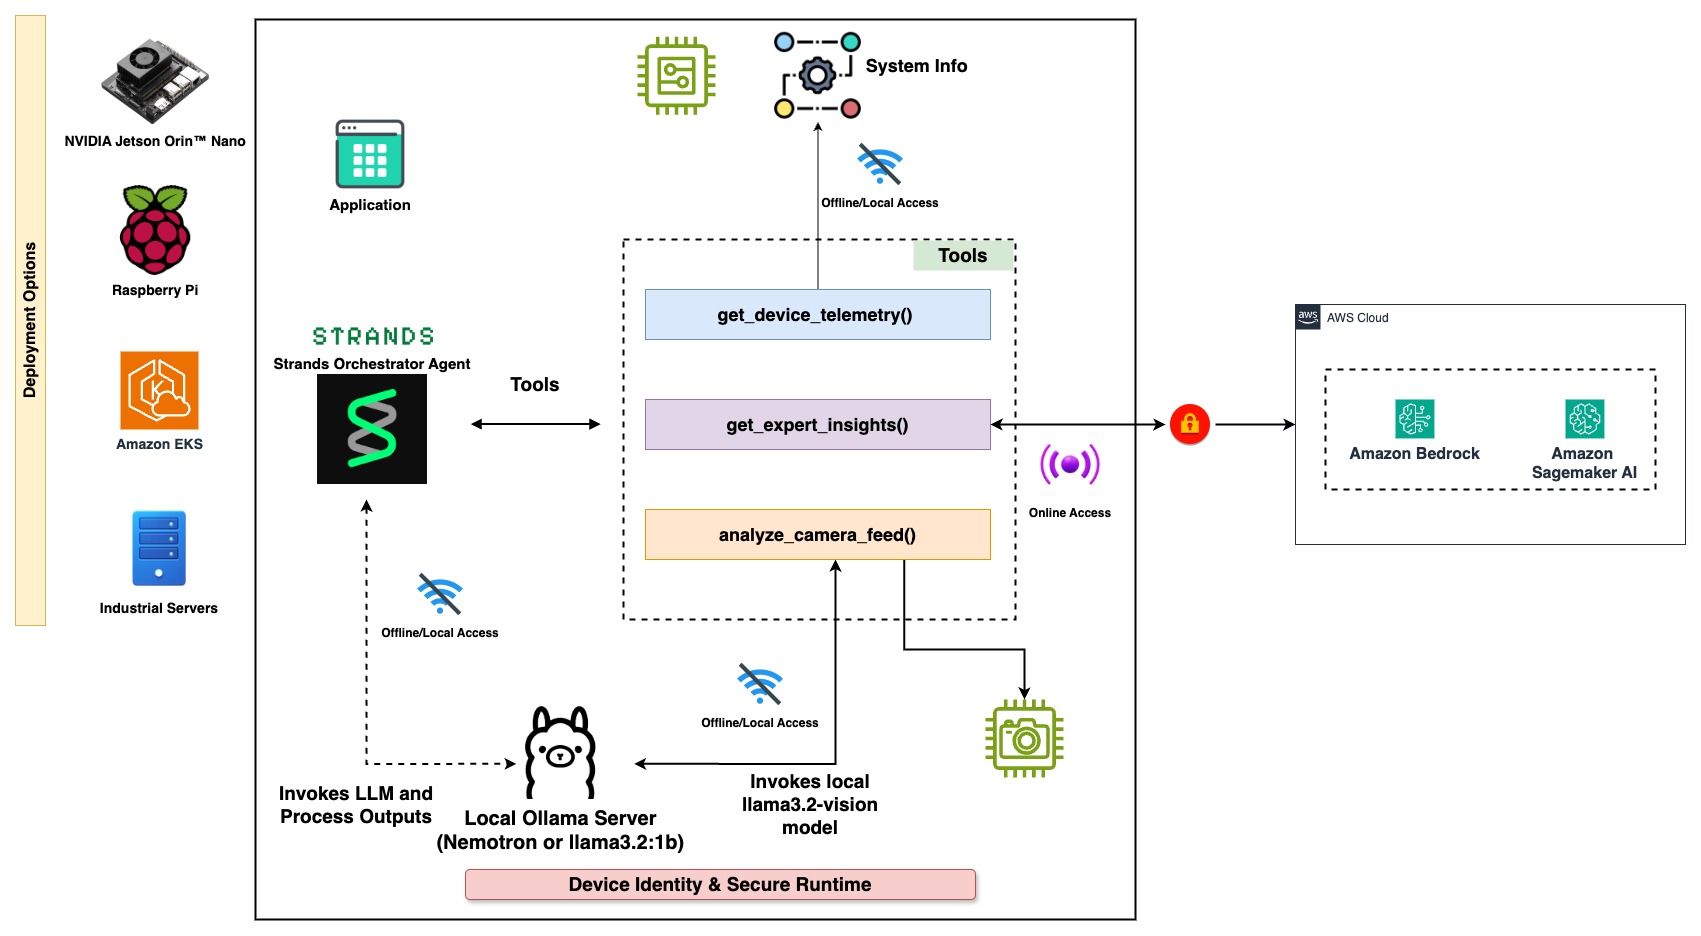
图 2:完整的 AAIF 系统架构,展示 Strands 智能体、Ollama 运行时、工具集成和 Amazon Bedrock 连接
该框架可适应你的部署约束,而不需要你围绕它重构基础设施。此架构可运行在内存为 8 GB 的 Raspberry Pi 等边缘设备上,也可用于所有推理都经由 Amazon Bedrock 的完整云部署,或结合本地速度与云端推理的混合配置。这种灵活性来自将路由逻辑(SLM 编排器)与处理工具分离,你可以根据可用硬件和网络连接情况独立替换或重新配置这些工具。
先决条件
本演练需要满足以下先决条件:
- 一个 AWS 账户。
- 在所需区域配置好 Amazon Bedrock 模型访问权限。
- 已安装 Python 3.10+。
- Ollama installed with the following models pulled:
ollama pull llama3.2:1b(编排器)。ollama pull llama3.2-vision(视觉分析)。
- 已安装 Strands Agents:
pip install strands-agents strands-agents-tools。 - 已配置好具有相应凭证的 AWS 命令行界面(AWS CLI)。
- 已安装 Boto3:
pip install boto3。
设置环境
创建项目目录并启动 Ollama 服务器:
mkdir aaif-demo && cd aaif-demo
ollama serve
拉取所需模型:
ollama pull llama3.2:1b
ollama pull llama3.2-vision
创建一个名为 aaif_agent.py 的文件,并添加以下组件。
实现本地处理工具
Strands Agents 使用 @tool 装饰器来定义智能体可调用的能力。首先创建用于本地处理的工具。
第一个工具用于检索设备遥测数据。在生产环境中,该工具会连接实际的 IoT 传感器。本演练使用模拟设备数据:
from strands import Agent, tool
import random

DEVICE_TELEMETRY = {
    "sensor-001": {
        "device_type": "Temperature Sensor",
        "location": "Building A - Floor 2",
        "temperature": 72.5,
        "humidity": 45.2,
        "status": "normal"
    },
    "camera-001": {
        "device_type": "Security Camera",
        "location": "Main Entrance",
        "fps": 30,
        "resolution": "1080p",
        "status": "recording"
    },
    "hvac-001": {
        "device_type": "HVAC Controller",
        "location": "Building A - Central",
        "set_temp": 71.0,
        "current_temp": 72.5,
        "mode": "cooling",
        "status": "active"
    }
}

@tool
def get_device_telemetry() -> str:
    """Retrieve current telemetry data from connected IoT devices."""
    device_id = random.choice(list(DEVICE_TELEMETRY.keys()))
    device_data = DEVICE_TELEMETRY[device_id]

    report = f"Device: {device_id} ({device_data['device_type']})\n"
    report += f"Location: {device_data['location']}\n"
    report += f"Status: {device_data['status']}\n"
    for key, value in device_data.items():
        if key not in ['device_type', 'location', 'status']:
            report += f"{key}: {value}\n"
    return report
第二个工具使用本地 SLM 执行视觉分析。llama3.2-vision 模型完全在本地硬件上运行,这意味着敏感的摄像头画面不会离开设备:
import ollama

@tool
def analyze_camera_feed(image_path: str) -> str:
    """Analyze visual data from cameras using local vision model."""
    stream = ollama.chat(
        model='llama3.2-vision',
        messages=[{
            'role': 'user',
            'content': 'Describe this image in one sentence. '
            'What are the 3 most important things you see?',
            'images': [image_path]
        }],
        stream=True,
    )

    full_response = ""
    for chunk in stream:
        chunk_content = chunk['message']['content']
        print(chunk_content, end='', flush=True)
        full_response += chunk_content

    return f"Object Detection Report:\n{full_response}"
实现云端处理
对于需要更广泛推理的复杂分析,创建一个调用 Amazon Bedrock 的工具。仅当编排器判断本地模型无法处理该请求时,才会调用此工具:
import boto3

@tool
def get_expert_insights(context_data: str, question: str) -> str:
    """Get advanced analysis and expert recommendations
    for complex questions via Amazon Bedrock."""
    client = boto3.client("bedrock-runtime", region_name="us-east-1")

    conversation = [
        {
            "role": "user",
            "content": [
                {"text": f"Context: {context_data}\n\nQuestion: {question}"}
            ],
        }
    ]

    response = client.converse(
        modelId="<<model_id>", //Refer model id [details](https://docs.aws.amazon.com/bedrock/latest/userguide/foundation-models-reference.html)
        messages=conversation,
        inferenceConfig={
            "maxTokens": 512,
            "temperature": 0.5,
            "topP": 0.9
        }
    )

    response_text = response["output"]["message"]["content"][0]["text"]
    return f"Expert Analysis:\n{response_text}"
使用智能编排配置 Strands 智能体
AAIF 的核心是 Strands 智能体配置。该智能体使用本地 SLM(llama3.2:1b)作为其编排器。Strands Agents 支持多个模型提供商,这里我们使用 Ollama 提供商在本地运行编排器:
from strands.models.ollama import OllamaModel

model = OllamaModel(
    model_id="llama3.2:1b",
    host="http://localhost:11434",
    params={
        "max_tokens": 300,
        "temperature": 0.3,
    },
)

system_prompt = """You are a monitoring assistant for operational facilities.
You have access to device telemetry tools, analysis capabilities,
and expert insights to help monitor operations effectively.

When users ask for:
- Device status or telemetry: use get_device_telemetry
- Image or data analysis: use analyze_camera_feed
- Expert advice or complex questions: use get_expert_insights

Always return the complete tool results directly to the user."""

agent = Agent(
    model=model,
    system_prompt=system_prompt,
    tools=[
        get_device_telemetry,
        analyze_camera_feed,
        get_expert_insights,
    ],
)
由 SLM 驱动的编排器会分析每个请求并将其路由到合适的工具,而无需硬编码关键词匹配。路由通过模型对请求的理解来完成:
| 请求 | 路由 | 延迟 |
| “检查设备状态” | 本地 SLM | 低(本地推理) |
| “分析这张图像” | 本地视觉 AI | 低(本地推理) |
| “你推荐哪些优化策略?” | 云端(Amazon Bedrock) | 较高(网络往返) |
表 1:本地推理与云端推理的请求、路由和延迟估算
运行智能体
配置好智能体后,你可以直接与其交互:
# Local processing - device telemetry
response = agent("What's the current status of our devices?")
print(response)

# Local processing - vision analysis
response = agent("Analyze the camera feed from camera-001")
print(response)

# Cloud processing - complex analysis
response = agent(
    "Based on current telemetry patterns, "
    "what optimization strategies do you recommend?"
)
print(response)
智能体会自动对每个请求进行分类,并将其路由到合适的处理层。无需显式路由规则。
适应不同的部署场景
AAIF 架构通过更改模型配置来适应不同的基础设施需求:
当你的工作负载完全在云端运行且没有可用的边缘硬件时,将所有处理所用的 Ollama 模型配置替换为 Amazon Bedrock。这样会将每个请求都路由到托管云推理,从而获得自动扩缩容能力,且无需本地 GPU 资源。拥有可靠低延迟连接且没有数据驻留限制的团队最能从这种配置中受益:
from strands.models import BedrockModel

model = BedrockModel(
    model_id="<<model_id>", //Refer model id [details](https://docs.aws.amazon.com/bedrock/latest/userguide/foundation-models-reference.html)
    region_name="us-east-1"
)
混合配置在保留本地 SLM 编排器的同时,为超出本地模型能力的请求增加云端模型。这是本演练中展示的默认 AAIF 配置。它适用于大多数请求足够常规、可在本地解决,但部分请求需要更大模型进行更广泛推理的环境。成本节省可来自约 80% 不访问付费 API 端点的流量。
对于完全物理隔离或具有严格数据主权要求的环境,请将云端工具替换为更大的本地模型,并在设备上运行所有处理。在内存充足的硬件上运行的 3B 参数模型可以处理中等复杂度的任务,否则这些任务会由 1B 编排器升级处理。代价是最困难查询的推理深度降低,但好处是数据不会离开本地:
model = OllamaModel(
    model_id="llama3.2:3b", # Larger local model for complex tasks
    host="http://localhost:11434",
)
展望:使用 MCP 服务器进行集中式工具调用
本文中的实现使用直接在代理代码中定义的本地工具调用。对于多个代理跨服务共享工具的生产部署,请将这些工具暴露为 Model Context Protocol (MCP) 服务器。MCP 提供用于工具发现和调用的标准化接口,因此你可以集中管理工具,并在不同代理和环境之间复用工具。在图 3 中,我们展示了如何将 AAIF 工具转换为 MCP 服务器,以实现分布式、集中式工具调用。
如图 3 所示的分布式配置中,Device 1 充当编排中心,运行带有 SLM 路由器和本地遥测工具的 Strands 代理。它通过 MCP 协议连接到 Device 2,后者运行带有 llama3.2-vision 的边缘视觉处理服务器。Device 3 充当连接到 Amazon Bedrock 的云分析网关。从编排器的角度来看,所有远程工具都表现为本地函数调用,因为 MCP 传输层会透明地处理序列化和网络通信。
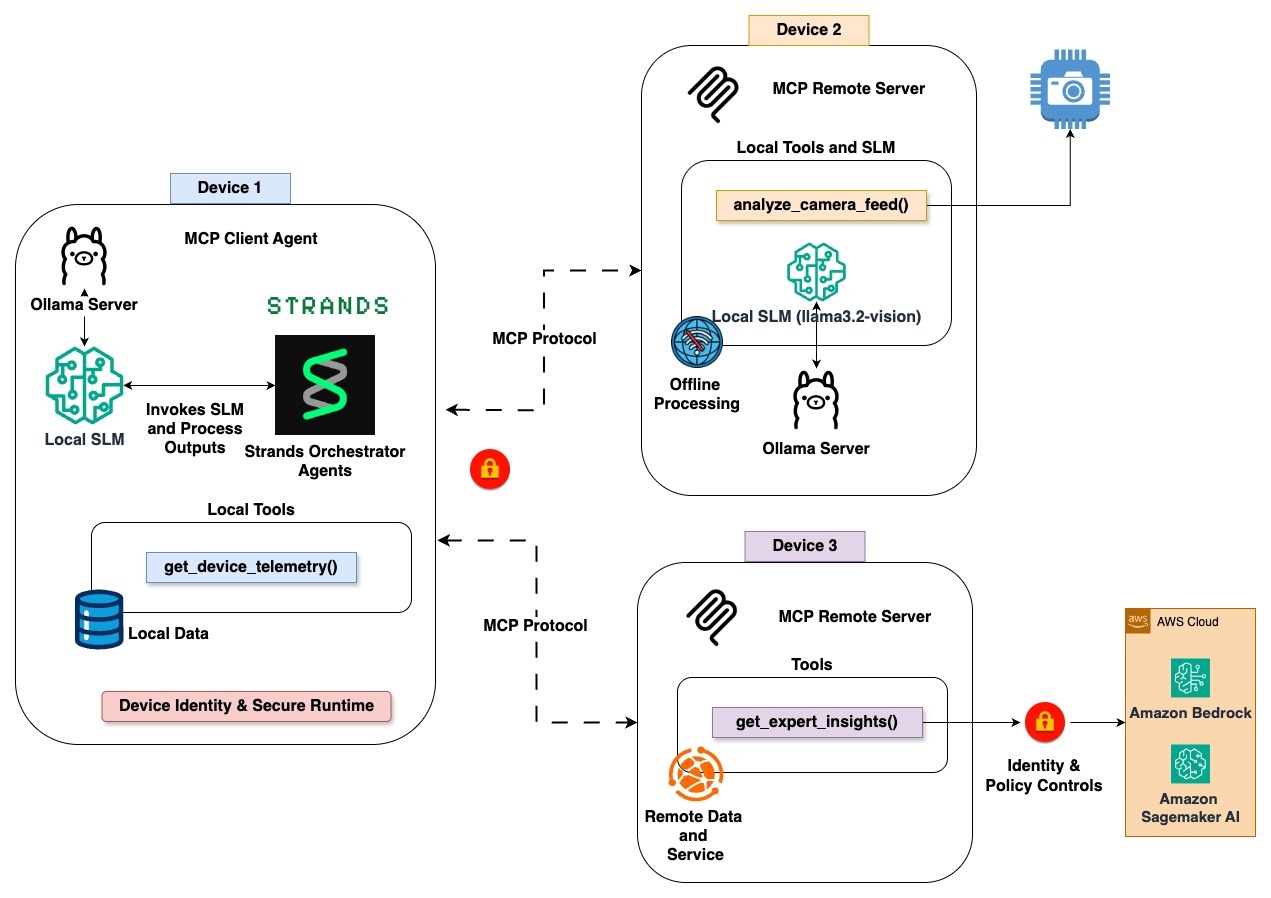
图 3:使用 MCP 服务器的分布式智能
清理
为避免产生未来费用,请完成以下清理步骤:
- 禁用 Amazon Bedrock 模型访问:打开 Amazon Bedrock 控制台,选择 Model access,并撤销对 Amazon Nova Lite 的访问权限。有关详细步骤,请参阅 Amazon Bedrock 用户指南中的 Manage model access。
- Stop the Ollama server and remove models to free local disk space (approximately 2 GB):
ollama stop ollama rm llama3.2:1b ollama rm llama3.2-vision - Delete the project directory if you no longer need the sample code:
rm -rf aaif-demo
结论
我们展示了如何使用 Strands Agents 和 Adaptive Agentic Intelligence Framework 构建经济高效的 AI 代理。通过将常规请求路由到本地 SLM,并将 Amazon Bedrock 上的云模型保留用于复杂分析,AAIF 可以帮助降低 API 成本,同时保持常规操作的低延迟。
在生产环境中运行此模式之前,请为云推理路径添加负责任的 AI 控制,因为这些请求会携带工具输出、检索到的数据和用户输入。你可以使用 guardrail ID 和版本将 Amazon Bedrock Guardrails 附加到 Strands BedrockModel。然后,它会应用针对有害类别的内容过滤器、提示注入过滤器,以及阻止源数据不支持的响应的上下文 grounding 检查。要将相同的策略应用于本地 SLM 层,请对其输入和输出调用独立的 ApplyGuardrail API。这样,无论由哪个模型处理,每个请求都遵循同一安全标准。
这种架构模式的应用范围不仅限于物联网监控。医疗机构可以在本地运行患者监控,同时将诊断支持请求路由到云端模型。金融服务公司可以在本地处理交易,并将云容量保留用于风险分析。制造团队可以在边缘运行质量控制视觉模型,同时将优化请求发送到云端。
要了解更多关于使用 Strands Agents 构建智能体的信息,请访问 Strands Agents 文档。有关可用基础模型的信息,请参阅 Amazon Bedrock。
关于作者

Nitin Eusebius
Nitin 是 AWS 的首席解决方案架构师,专攻生成式 AI 和智能体系统。他专注于帮助客户在云和边缘环境中构建智能且经济高效的 AI 解决方案。

Mani Khanuja
Mani 是 AWS 的首席解决方案架构师,专注于 AI/ML 和生成式 AI。她帮助客户采用可扩展的 AI 解决方案,并热衷于推进负责任的 AI 实践。
来源:AWS Machine Learning Blog · aws.amazon.com