i14 在 AWS Trainium2 上用原生 PyTorch 训练与部署 Laplace 3B 线性注意力模型
Beyond the KV cache: Training and serving i14’s Laplace 3B linear attention model on AWS Trainium2 with native PyTorch
i14 与 AWS 合作,通过 TorchNeuron Native 将采用 Gated Linear Attention 的 Laplace 3B 移植到 AWS Trainium2,保留了 GLA 架构与 Muon 优化器。
原文给出线性注意力模型在 Trainium2 上的三项改造细节与实测吞吐,可作为自定义架构移植的工程参考。
大多数大型语言模型(LLM)采用带有 softmax 注意力的 transformer 架构。在推理过程中,其键值(KV)缓存会随着对话或文档上下文而增长。这会降低并发能力、增加服务成本,并迫使智能体应用丢弃有用的历史记录。
i14 将 Laplace 3B 设计为一种线性注意力替代方案。其循环状态在每个序列中保持在 29.5 MB,与上下文长度无关。i14 与 AWS 合作,利用 通过 TorchNeuron Native 提供的原生 PyTorch 支持,将这一自定义架构引入 AWS Trainium2。这保留了其门控线性注意力(GLA)设计和 Muon 优化器。
在一台 trn2.48xlarge 实例上,Laplace 3B 的训练速度约为每秒 120,000 个 token。该模型在 1,280 个并发序列上实现了每秒 11,544 个输出 token 的服务能力。本文介绍了模型设计、i14 为 Trainium2 所做的改动,以及训练和推理结果。
关于 i14
i14 是一家 AI 研究与技术公司,开发模型架构、组件和运行时。其工作借鉴了 AI、计算认知科学,以及关于生物系统如何随时间学习的研究。i14 将这些理念应用于能够保留长程上下文、同时又不让服务状态随每个 token 增长的模型。
为什么选择线性注意力模型?
Transformer softmax 注意力会在上下文中比较各个 token。在训练期间,这种计算量随序列长度呈二次增长。在推理期间,KV 缓存会随着模型处理更多 token 而增长。
线性注意力围绕一个循环状态重新组织计算,该状态会针对每个 token 进行更新。Laplace 3B 使用 GLA 将先前的上下文压缩为固定大小的矩阵状态。这将训练注意力从 O(T2) 变为 O(T),并将推理状态固定为每个序列 29.5 MB。
| 考量因素 | Transformer softmax 注意力 | 采用 GLA 的 Laplace 3B |
| 训练注意力 | 以 O(T2) 的扩展方式构建成对 token 分数 | 以 O(T) 的扩展方式更新分块循环状态 |
| 推理内存 | KV 缓存随上下文增长 | 循环状态大小保持固定 |
| 更长的上下文 | 每个序列消耗更多加速器内存 | 上下文长度不会增加循环状态分配 |
| 实现 | 使用广泛优化的注意力内核 | 需要特定于架构的内核和编译器调优 |
线性注意力压缩历史,而不是保留每个键和值。因此,你必须针对自己的工作负载评估检索质量。固定状态可惠及长时间运行的智能体、大型文档分析,以及需要持久内存且服务需求可预测的应用。
i14 如何为 AWS Trainium2 适配 Laplace 3B
Laplace 3B 的原始实现使用了针对 GPU 优化的 Triton 内核。AWS 生成式 AI 创新中心(GenAIIC)团队首先使用标准 PyTorch 算子为 Trainium2 重写了 GLA 内核。在比较两种方案后,团队选择了 TorchNeuron Native(AWS Trainium 的原生 PyTorch 后端)的 beta 版本,因为它的性能更好。
该实现需要三项改动:
- 为 GLA 注意力内核使用原生 PyTorch。团队用标准 PyTorch 算子替换了 GPU 专用的 fused_chunk_simple_gla Triton 内核,使用 16 个 128 token 的分块来匹配 NeuronCore 片上缓冲区的 128 个分区。
- 重新设计 Muon 的通信方式。MuonFSDP2 中的两次 all_to_all 集合通信将每卡流量削减了 24 倍,并将吞吐量提升了 1.63 倍。
- 编译顺序反向传播。团队静态展开了 GLA 循环的 16 个分块步骤,以适配编译器的图大小和片上内存限制。
工程挑战部分详细描述了每一项改动。
为什么选择 AWS Trainium 加速器?
AWS Trainium 是 AWS 面向模型训练和推理设计的一系列机器学习(ML)加速器。一台 trn2.48xlarge 实例集成了 16 颗 Trainium2 芯片、64 个逻辑 NeuronCore、高带宽内存以及 NeuronLink-v3 互连。这些资源支撑了本文所述的分布式训练和推理配置。
Trainium2 的三个特性塑造了实现方式:软件管理的片上内存(挑战 1)、快速的芯片间互连(挑战 2)以及静态编译器(挑战 3)。编译器将 GLA 循环追踪为一张固定图。
软件管理的片上内存。每个 NeuronCore 拥有一个 28 MiB 的状态缓冲区(SBUF,含 128 个分区)和一个 2 MiB 的部分和缓冲区(PSUM)。PSUM 与一个 128×128 的脉动张量引擎相连,旁边还有独立的向量单元和标量单元。SBUF 不是缓存:编译器会提前调度每一次 HBM-to-SBUF 传输,因此数据就位,不会发生驱逐或缺失(图 1)。
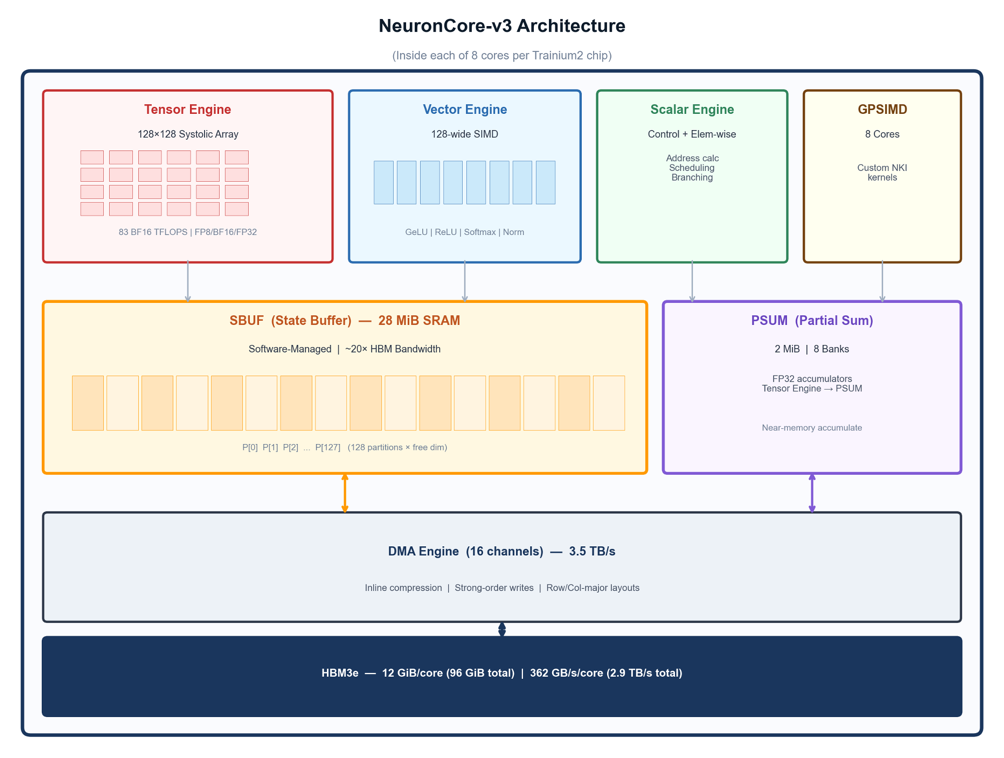
图 1:NeuronCore-v3 内部架构。软件管理的 SBUF(28 MiB,128 个分区)、张量引擎(128×128 脉动阵列)、向量引擎、标量引擎以及 GPSIMD 核心。
i14 与 Laplace 3B 架构
Laplace 3B 是 24 层的 i14 解码器,其中每一层都用 Simple GLA 替代了 softmax 注意力。图 2 追踪了一层从顶部的输入 xt 到底部的输出 xt + 1。本节将解释各个模块:归一化与卷积、QKVG 投影、GLA 混合器以及前馈通道混合器。
归一化与卷积。每个 token 的残差流向量 xt ∈ ℝD(D = 3,072)经过一个 LayerNorm 和一个宽度为 k = 4、带 SiLU 的深度可分离因果 Conv1d。这使每个位置在进入混合器之前都获得一个 4-gram 摘要。随后,GLA 混合器通过其衰减状态在整个历史上进行基于内容的检索。
QKVG 投影。卷积后的输出经过一个融合矩阵 Wqkvg ∈ ℝ9, 216 × 3, 072,其中 9, 216 = H × (2dk + 2dv)。它被拆分为四个逐 token 的流:查询 qt、键 kt、值 vt 以及门控 gt(H = 16,dk = 96,dv = 192)。门控在混合器之后使用。
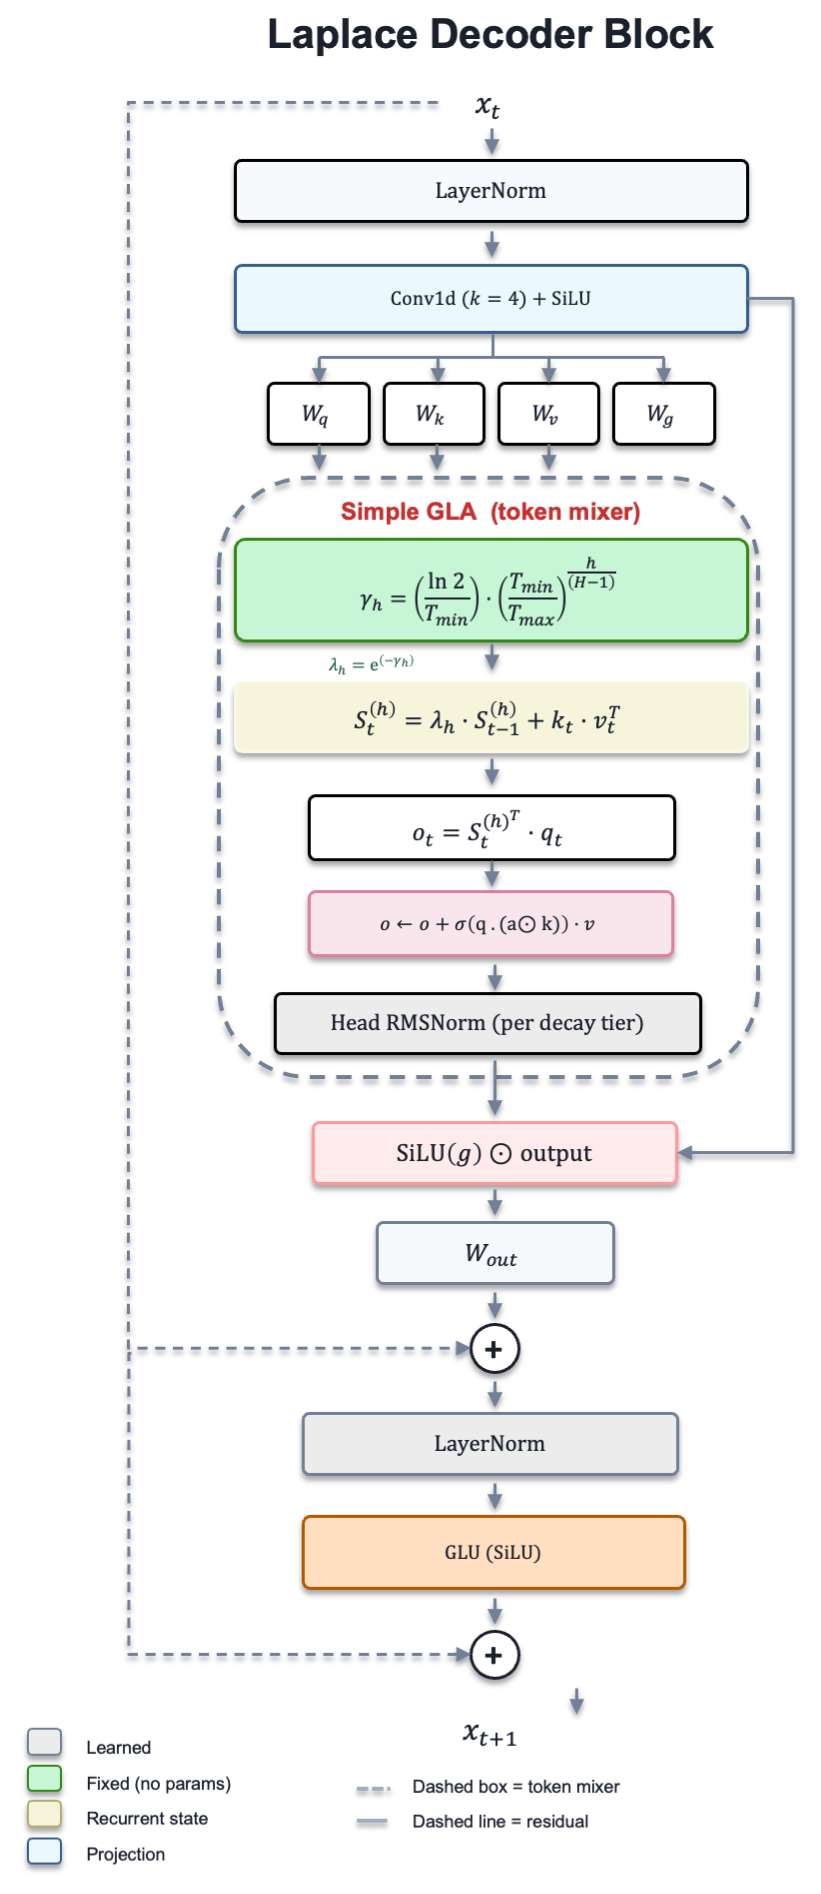
图 2:Laplace 解码器层架构。绿色 = 固定(无参数),灰色 = 可学习,黄色 = 循环状态,蓝色 = 投影。
GLA 混合器。 每个头 h 维护一个大小为 dk × dv(96 × 192)的矩阵状态 St(h),这是过去键值对的压缩、衰减记录。在每个 token 处,它按如下方式更新:
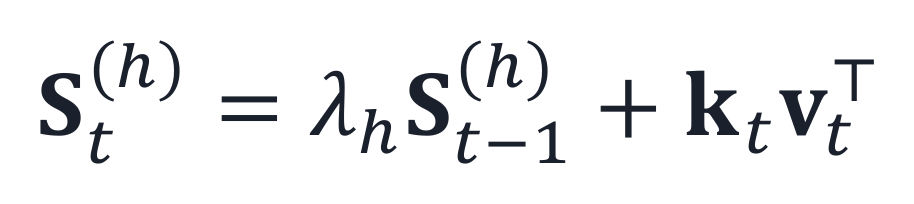
GLA 循环状态更新方程
这里 λh 是固定的每头衰减率,ktvt⊤ 是将当前键值对写入状态的秩-1 外积。读出时查询该状态:
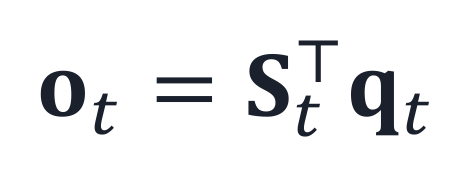
GLA 状态读出方程
接下来,一个自增强步骤将值的门控副本加到每个头的输出上:
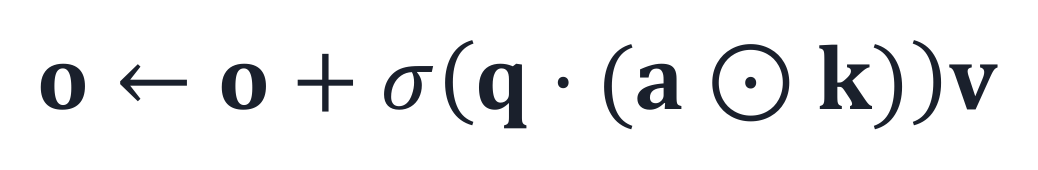
GLA 自增强方程
这里 σ 是 sigmoid,⊙ 是逐元素乘积。门控是查询与键的逐通道学习缩放的点积,其中 a 是学习到的缩放(aug_balance)。初始化时,a = 0,这给出值的一半强度跳跃连接。每个头的输出在每个衰减层级内通过 Head RMSNorm,被拼接,由 SiLU(gt) 门控,并由 Wout ∈ ℝD × D 投影回残差流。
衰减调度。 每头衰减率 λh 控制一个头遗忘过去 token 的速度。它在初始化时固定(不学习),由几何调度设定。该调度为 16 个头提供了一系列记忆长度,并定义每个头的对数衰减率 γh:
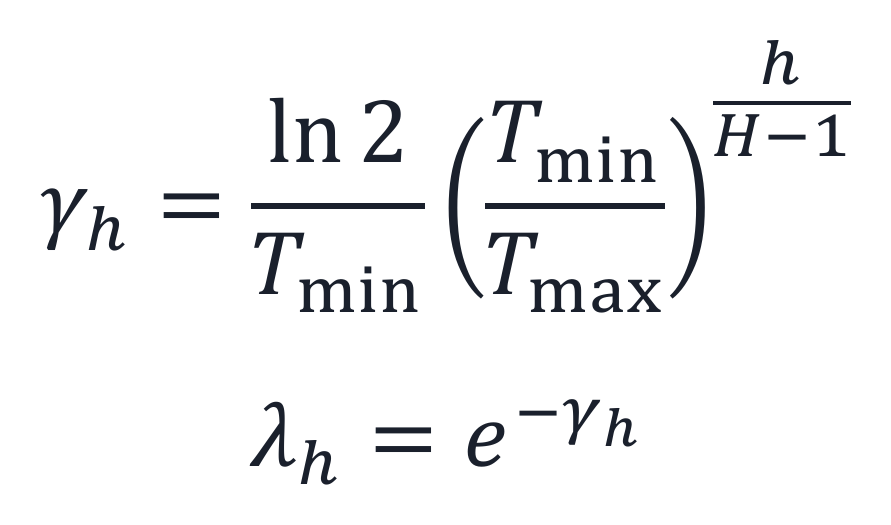
GLA 衰减调度方程
衰减调度的覆盖范围。 对于此模型,Tmin = 1 且 Tmax = 2,048。因此头 0 有 λ0 = 0.5(一个 token 的半衰期),头 15 有 λ15 ≈ 0.9997(2,048 个 token 的半衰期)。头被分组为层级,每个层级共享一个 Head RMSNorm。
通道混合器(FFN)。 在注意力块及其残差之后,第二个 LayerNorm 馈入一个内维度为 8,192 的 GLU(SiLU)FFN。其三个矩阵是两个上投影 W1, W2 ∈ ℝ8, 192 × D 和一个下投影 W3 ∈ ℝD × 8, 192。随后是第二个残差。
状态 S(h) 固定为每个头 dk × dv = 96 × 192,与序列长度无关。因此,推理为每 token O(1),训练为 O(T) 而非 O(T2)。
| 参数 | 值 |
| 参数 | 总计 3.028B(2.718B Muon + 309.6M AdamW) |
| 层数 | 24 个解码器层,D = 3,072 隐藏维度 |
| 头数 | 16 个头,dk = 96(半宽 Q/K),dv = 192(全宽 V) |
| Mixer | 带固定几何衰减的简单 GLA(Tmin = 1,Tmax = 2,048) |
| Conv | 深度可分离因果 Conv1d,卷积核宽度 4,SiLU |
| FFN | GLU(SiLU),内部维度 8,192 |
| Norm | LayerNorm pre-attn + Head RMSNorm(按层级)+ LayerNorm pre-FFN |
| Vocab | 50,304(填充至 64 的倍数) |
| Sequence | 2,048 |
| Training data | 100B tokens,FineWeb-Edu |
| Optimizer | 二维权重矩阵使用 Muon;嵌入和归一化使用 AdamW |
| Batch size | 524,288 tokens/步,余弦学习率,3,815 步预热 |
工程挑战
这三项改动各自带来了自己的工程挑战。
挑战 1:在 Trainium 上使用原生 PyTorch 实现 GLA
在 GPU 上,GLA 以 flash-linear-attention 库中的融合 Triton 内核 fused_chunk_simple_gla 运行。GenAIIC 团队用通过 TorchNeuron Native 运行的标准 PyTorch 算子重新表达它,即对固定大小分块进行显式循环。分块数量在编译时固定,并决定反向展开深度。团队使用 fla_num_chunks = 16,因此每个分块包含 C = 128 个 token。
在每个分块 c 内,块内输出是带掩码的线性注意力,运行状态 S 会累加更早的上下文:
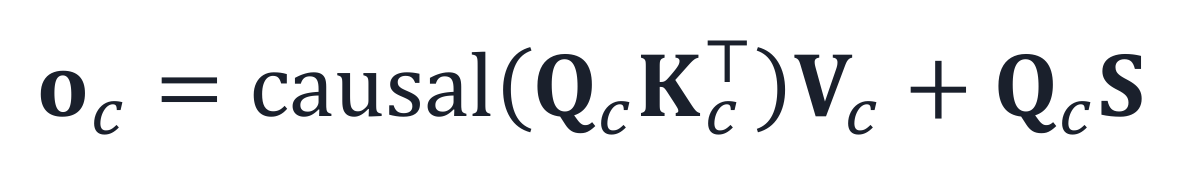
分块 GLA 的块内输出
随后状态推进到下一个分块:
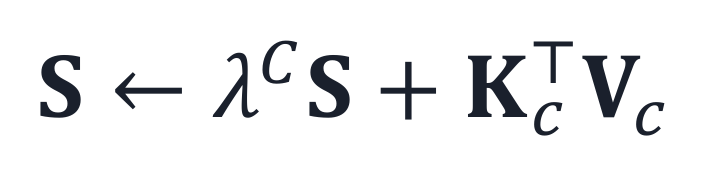
分块 GLA 的状态更新
这里 λC 是每个头在分块上复合后的衰减。16 个块内计算并行运行,只有状态更新是串行的(图 3)。
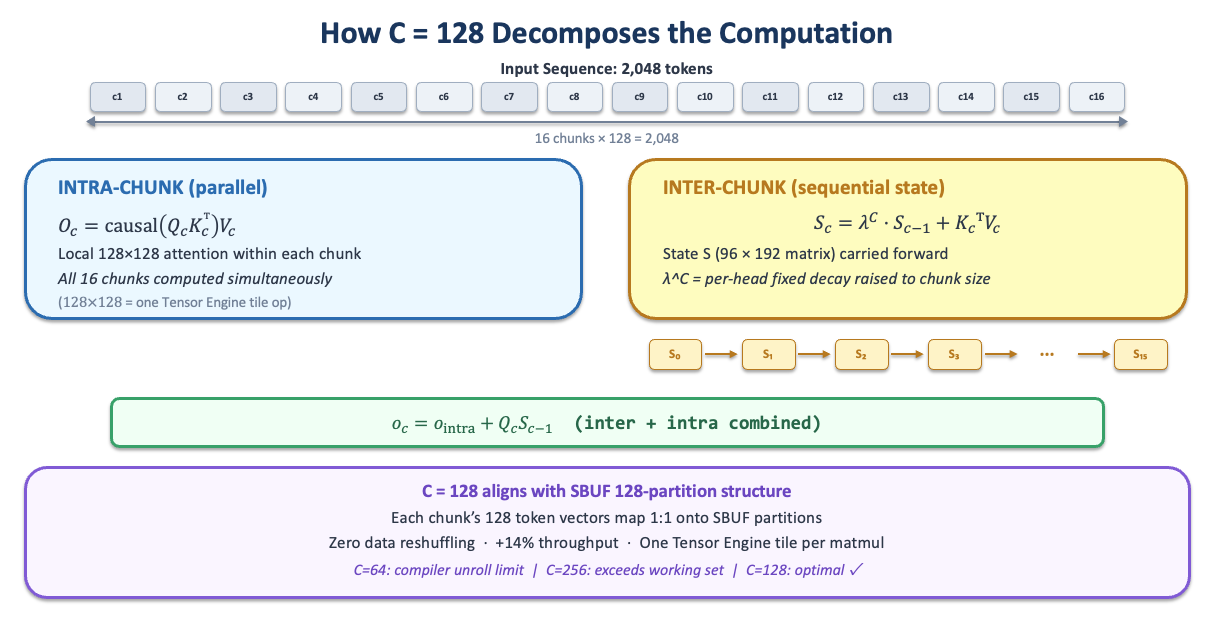
图 3:GLA 分块循环,块内注意力并行,状态链串行。
由于 SBUF 有 128 个分区,每个 128 token 的分块将每个 token 映射到一个分区,无需填充或跨分区移动。这种对齐使实测吞吐量提高了 14%(图 4)。
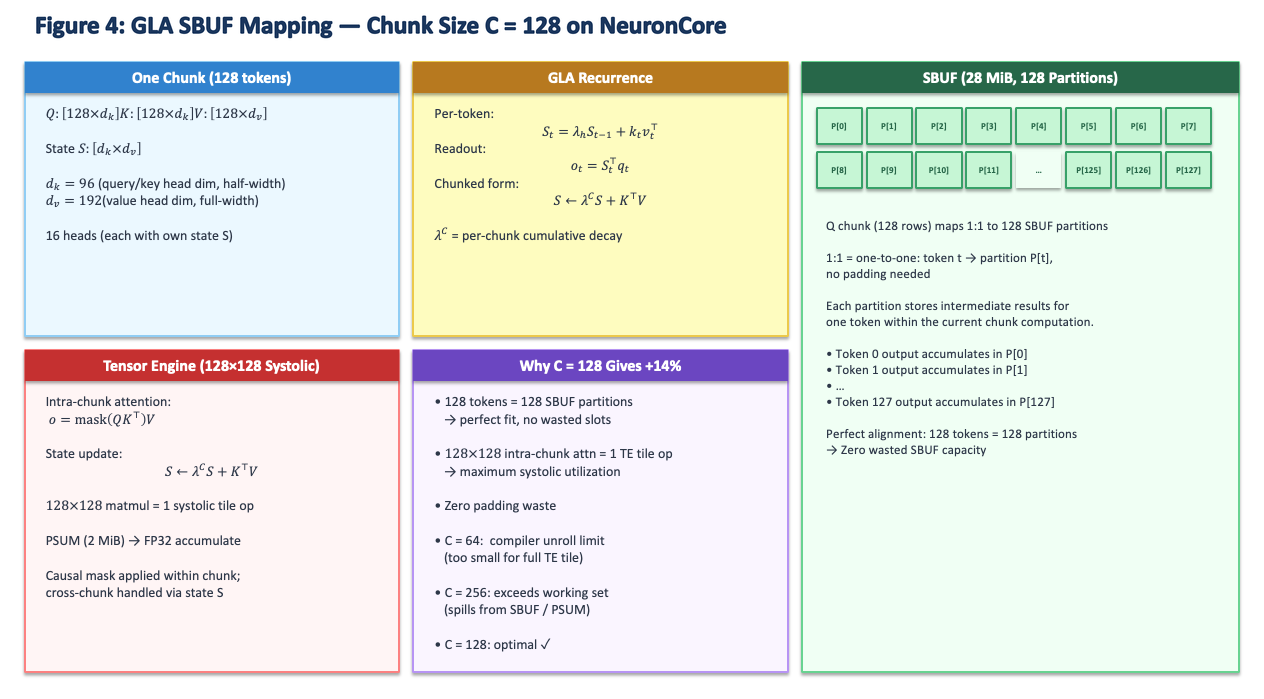
图 4:分块大小 C = 128 与 128 个 SBUF 分区一一对应。
挑战 2:FSDP2 下的分布式 Muon 正交化
Muon 在更新前对每个梯度进行正交化。对于 96 个二维权重矩阵(27.18 亿参数)中的每一个,它运行五次 Newton–Schulz 迭代(算法 1)。
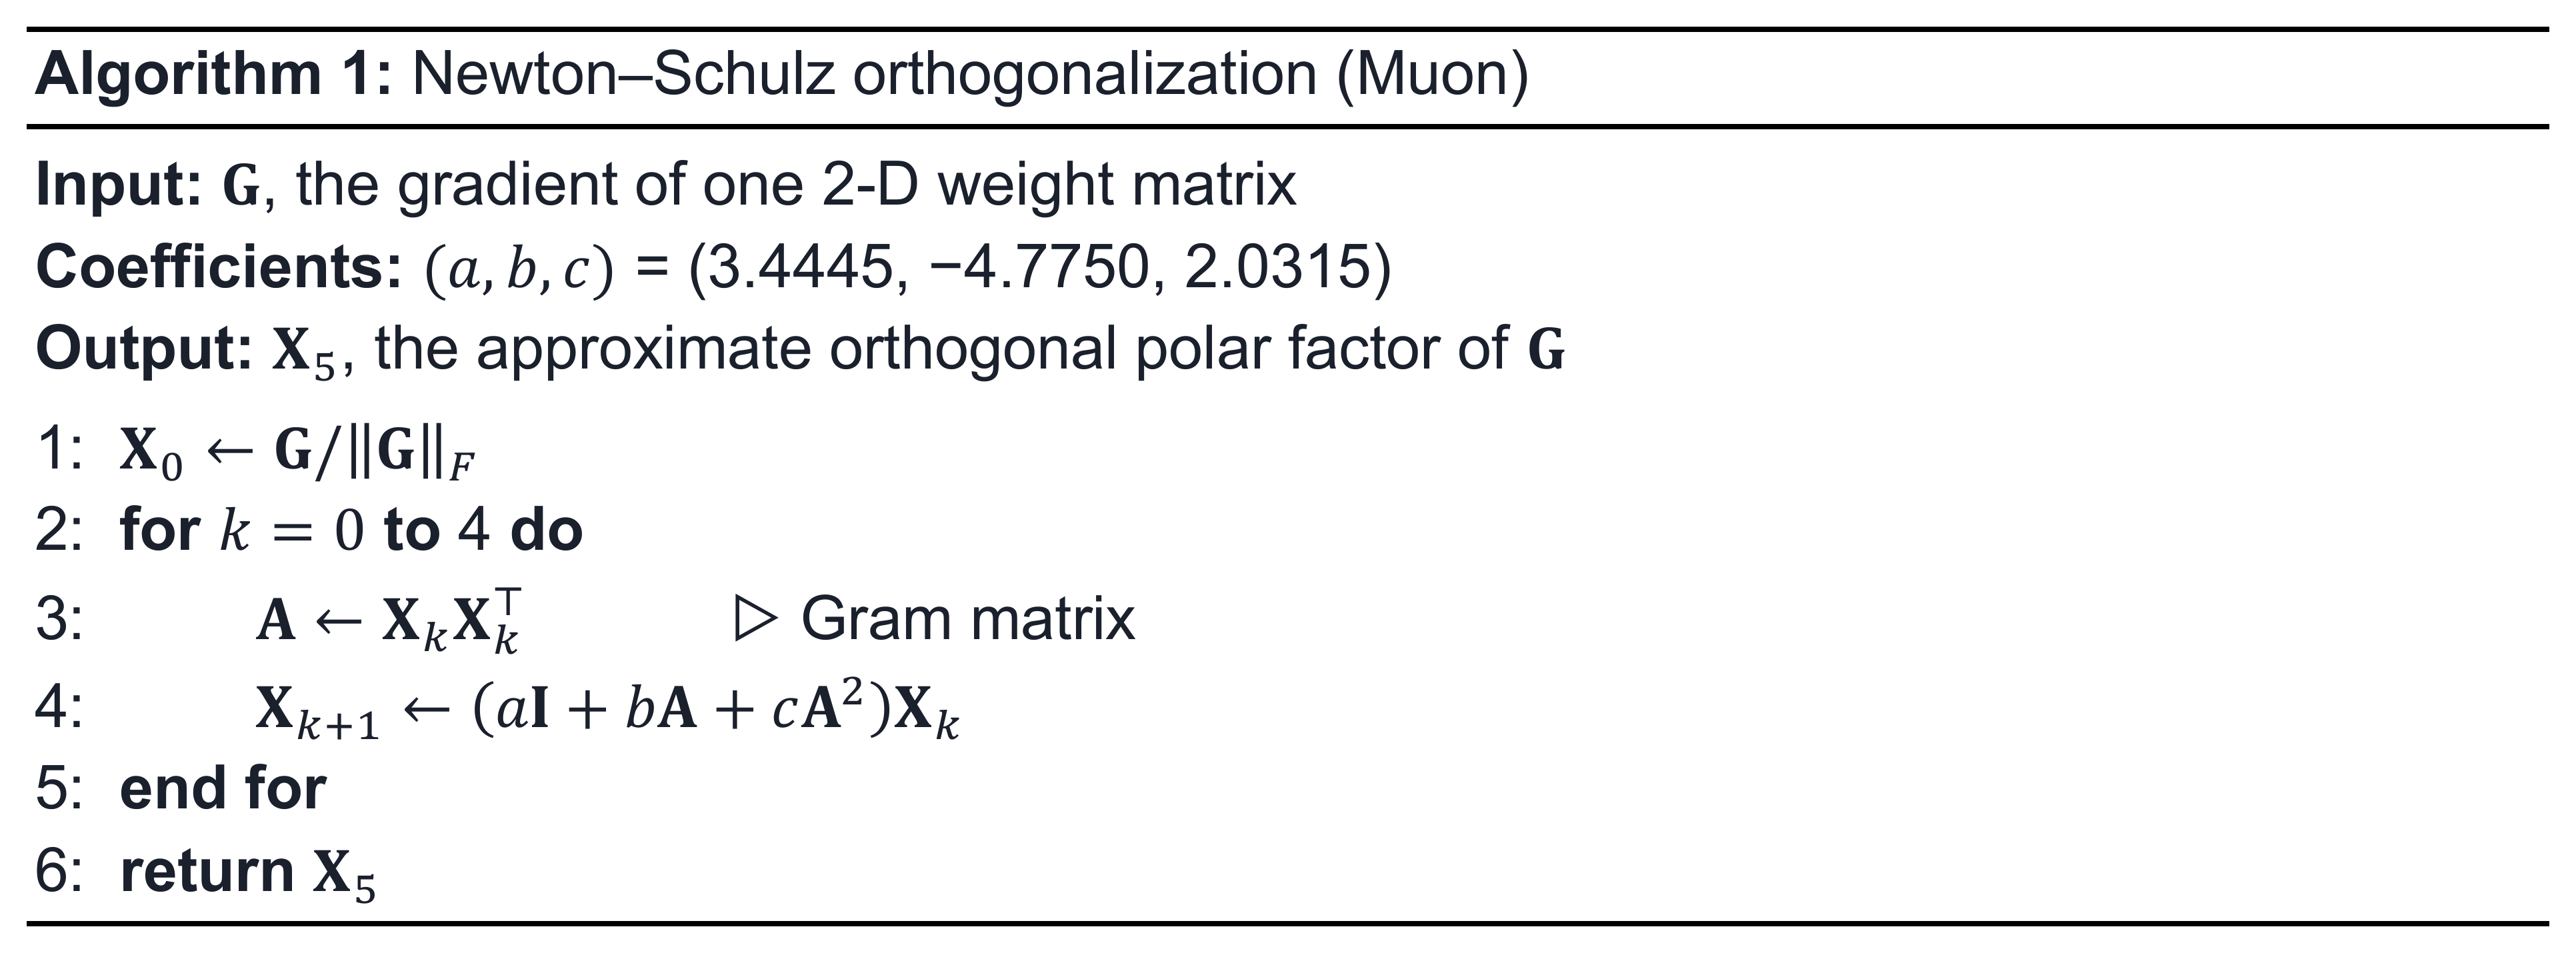
Newton-Schulz 算法
分布式问题。 Gram 矩阵 A = XX⊤ 将权重的每一行与所有其他行相关联。在完全分片数据并行(FSDP2)下,64 个 rank 中的每一个只持有 1/64 的行。因此,分片本地的 XX⊤ 只能得到对角块,并丢弃所有跨分片项(图 5)。
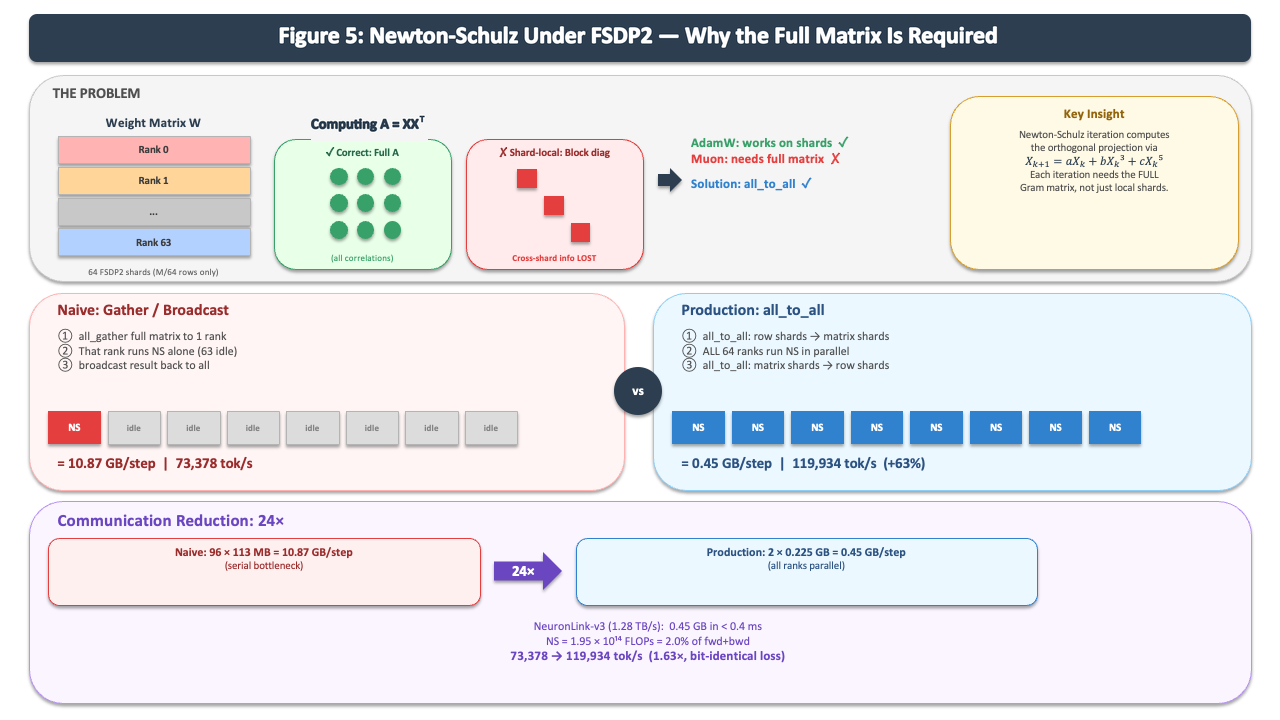
图 5:FSDP2 下的 Newton–Schulz:分片本地 Gram 块,以及 gather/broadcast 与 all_to_all 的对比。
朴素方法:Gather 和 broadcast。 每个 rank 收集完整梯度(5.44 GB),一个 rank 运行 Newton–Schulz,然后广播结果。这样每步移动 10.87 GB,而其他 63 个 rank 处于等待状态。
生产方案:all_to_all 转置。在 MuonFSDP2 中,一次 all_to_all 让每个 rank 获得若干完整矩阵,全部 64 个 rank 并行运行 Newton–Schulz,第二次 all_to_all 返回结果。单 rank 通信量降至 0.45 GB,减少了 24 倍。吞吐量从每秒 73,378 个 token 提升至 119,934 个,提高了 1.63 倍,且损失曲线逐位一致(图 6)。
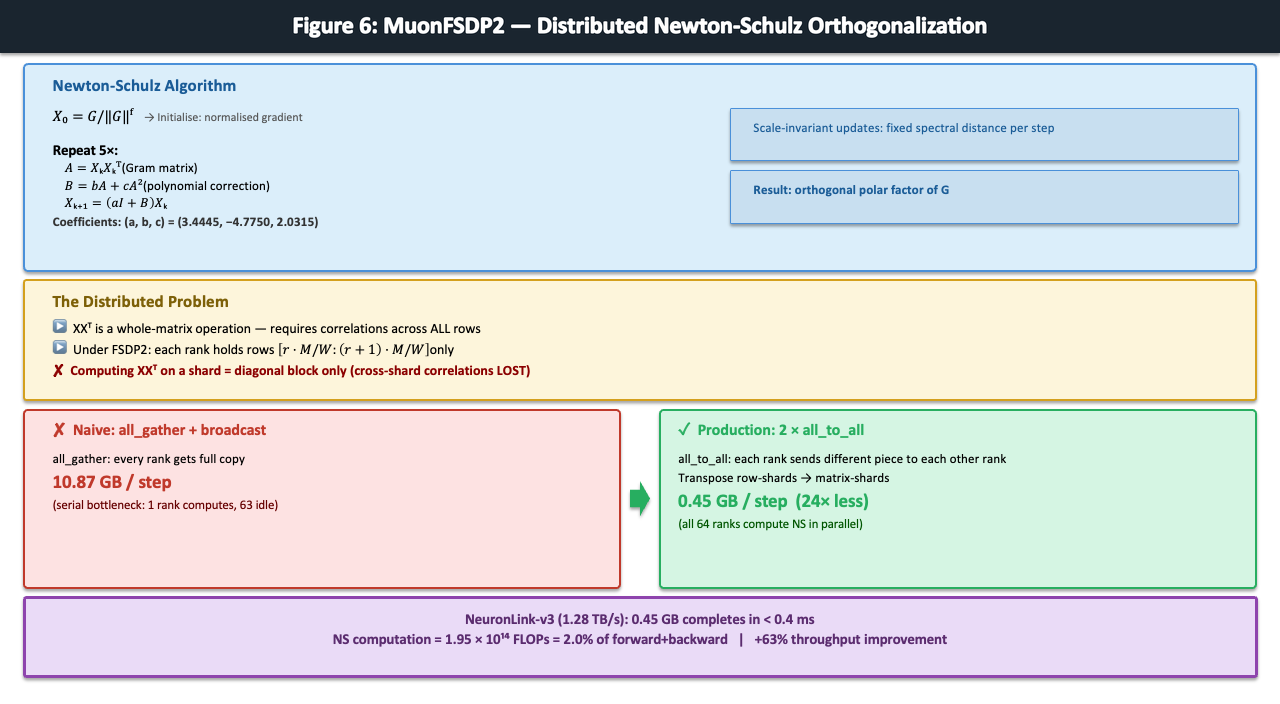
图 6:每步通信量:all_gather 为 10.87 GB,all_to_all 为 0.45 GB。
通信开销。Newton–Schulz 仅占训练步骤 FLOPs 的约 2%(9.53 × 10¹⁵ 中的 1.95 × 10¹⁴),因此通信才是瓶颈。在 1.28 TB/s 的 NeuronLink-v3 上,0.45 GB 的数据交换耗时不到 0.4 ms,而整个步骤约需 4.4 秒。
挑战 3:为顺序递归展开反向传播
反向传播需要对全部 16 次顺序状态更新求导。在 GPU 上,autograd 在运行时构建该计算图。在 Trainium2 上,编译器必须提前看到完整的 16 步展开图,这带来三个约束。
图深度随 chunk 数量增长:在 32 个 chunk(C = 64)时,图超出了调度器容量。每 chunk 内存随 chunk 大小增长:在 8 个 chunk(C = 256)时,中间结果溢出到 HBM。所有形状在 trace 时固定,因此每个循环中间结果都需要自己的静态分配。
16 个 chunk(C = 128)同时满足全部三个约束:展开图适配调度器,中间结果留在片上,tile 与 128 个 SBUF 分区对齐。
训练结果
GenAIIC 团队在一个 trn2.48xlarge 实例上使用全部 64 个逻辑 NeuronCore 和 all_to_all Muon 路径训练了 Laplace 3B。完整配方为 190,735 步(1000 亿 FineWeb-Edu token)。以下结果截至第 84,210 步,约 440 亿 token。
吞吐量。编译预热后,吞吐量稳定在约每秒 120,000 个 token,并一直保持到第 84,210 步。
损失与梯度稳定性。损失(图 7a)从约 11.4 平滑下降到第 84,210 步的 2.3729。梯度范数(图 7b)呈现预期的早期尖峰,随后稳步下降至约 0.05,预热后没有尖峰、发散或 NaN/Inf 值。
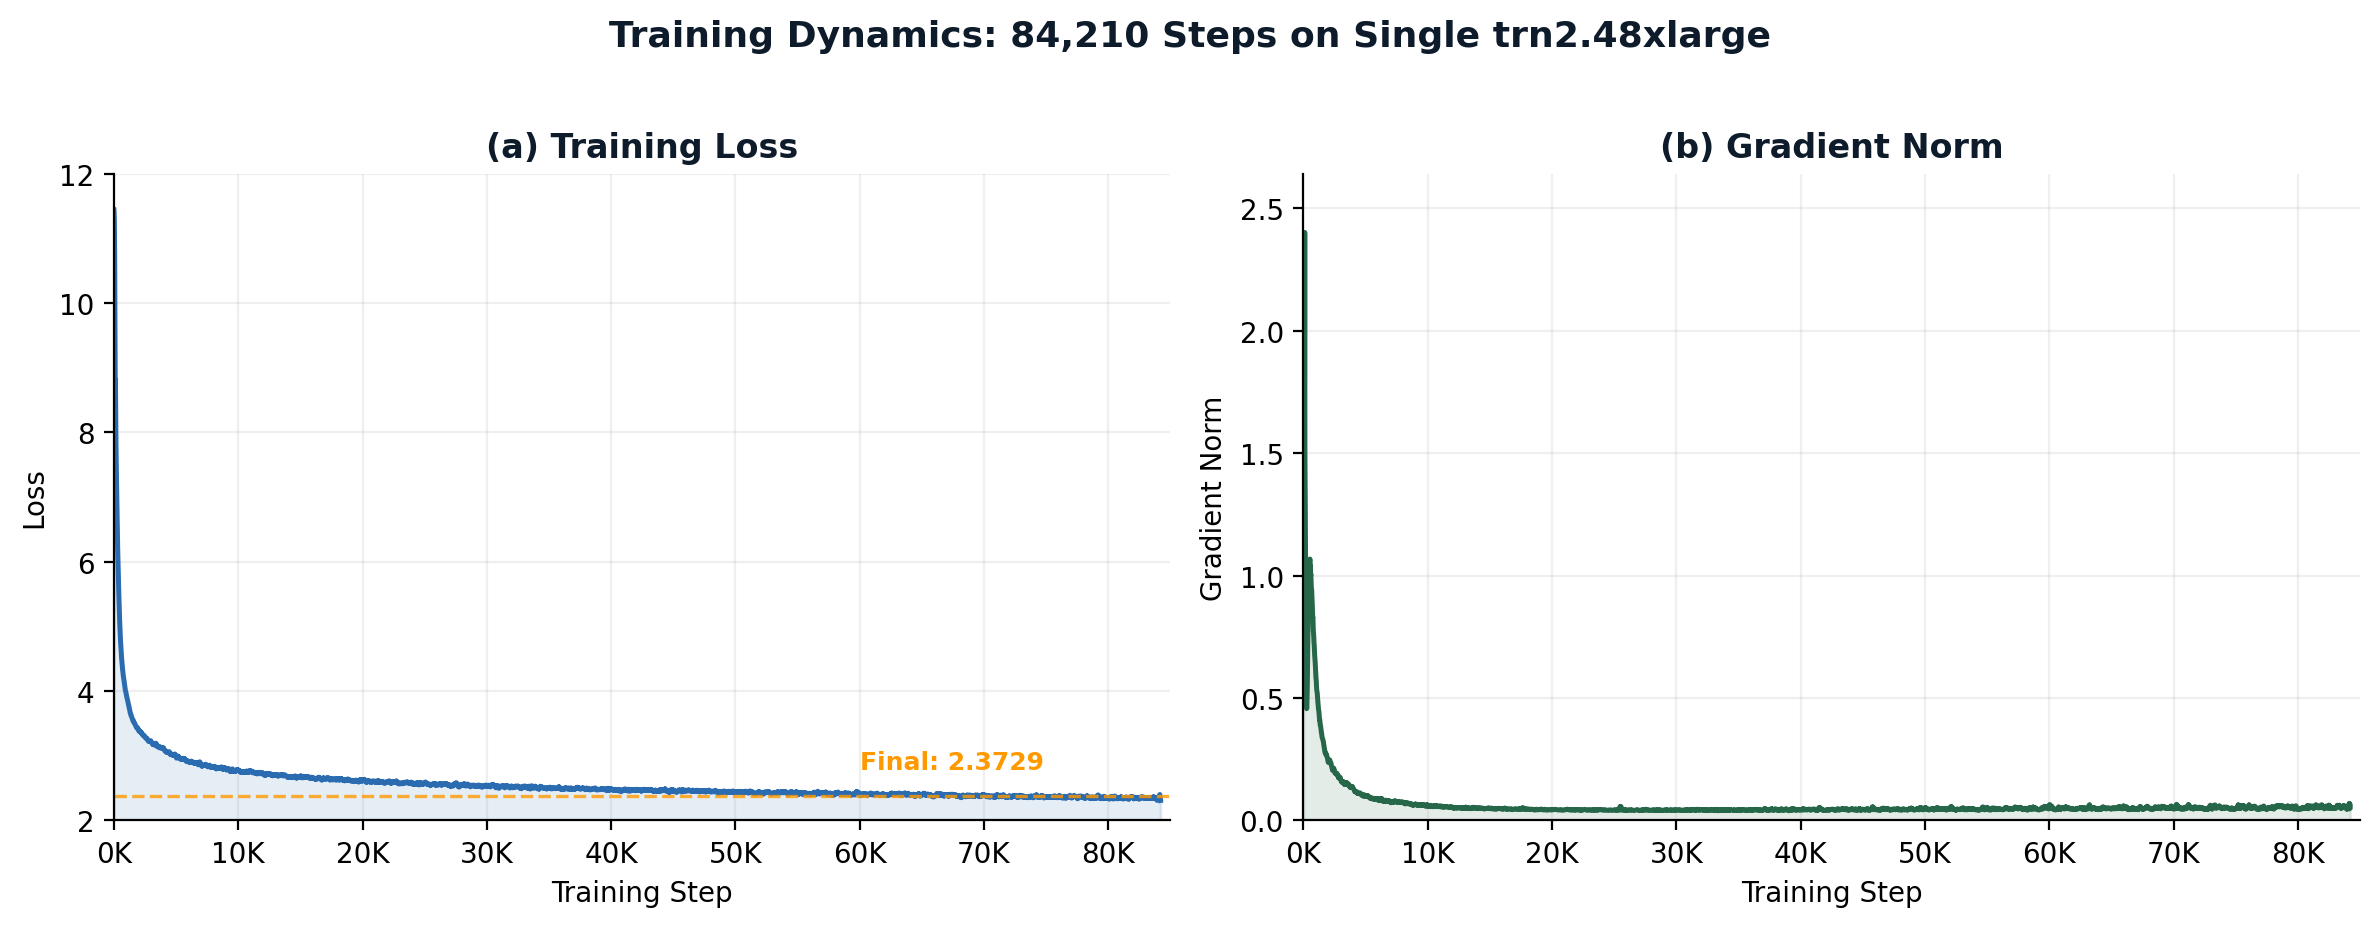
图 7:训练动态。(a) 损失 11.4 → 2.3729。(b) 来自 TensorBoard 数据的梯度范数。
Trainium2 上的推理优化
通过未修改的 vLLM 引擎,GenAIIC 团队在一个 trn2.48xlarge 实例上以 1,280 个并发序列实现了每秒 11,544 个输出 token。
恒定服务状态。每个序列 29.5 MB 的递归状态比 8,192 token 时可比 KV cache 小约 82 倍。将 prompt 从 2,048 token 增加到 8,192 token,仅使每个输出 token 的成本增加 0.5%。
未修改的 vLLM。一个包装器替换每个解码器层的一个属性——token mixer——以在 vLLM 池中读写递归状态。由于模型声明自身无注意力,vLLM 为每个序列分配一个固定页。输出与 i14 参考逐 token 匹配(BF16 下 3/3 个 prompt 的 48/48 步)。
寻找瓶颈。将解码时间对解码器层数 L 进行线性拟合得到:
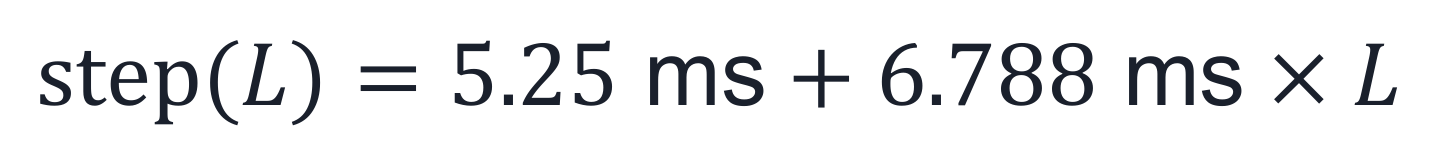
At L = 24, that is 168.1 ms per step, 96.9 percent of it inside the decoder layers. The large projections cost 13.27 ms, near the 12 ms HBM-streaming floor. Most time went to small operators dispatched one at a time under eager PyTorch.
扩展到完整实例。 在没有张量并行的情况下,吞吐量通过副本扩展,每个逻辑 NeuronCore 使用一个引擎和 20 个序列。Eager 吞吐量从单个副本上的每秒 133 个输出 token 增长到 64 个副本上的 6,772 个,此时主机 CPU 使用率达到 82%。编译解码步骤消除了逐算子调度,并将吞吐量提升 1.7 倍,达到 11,544(图 8)。
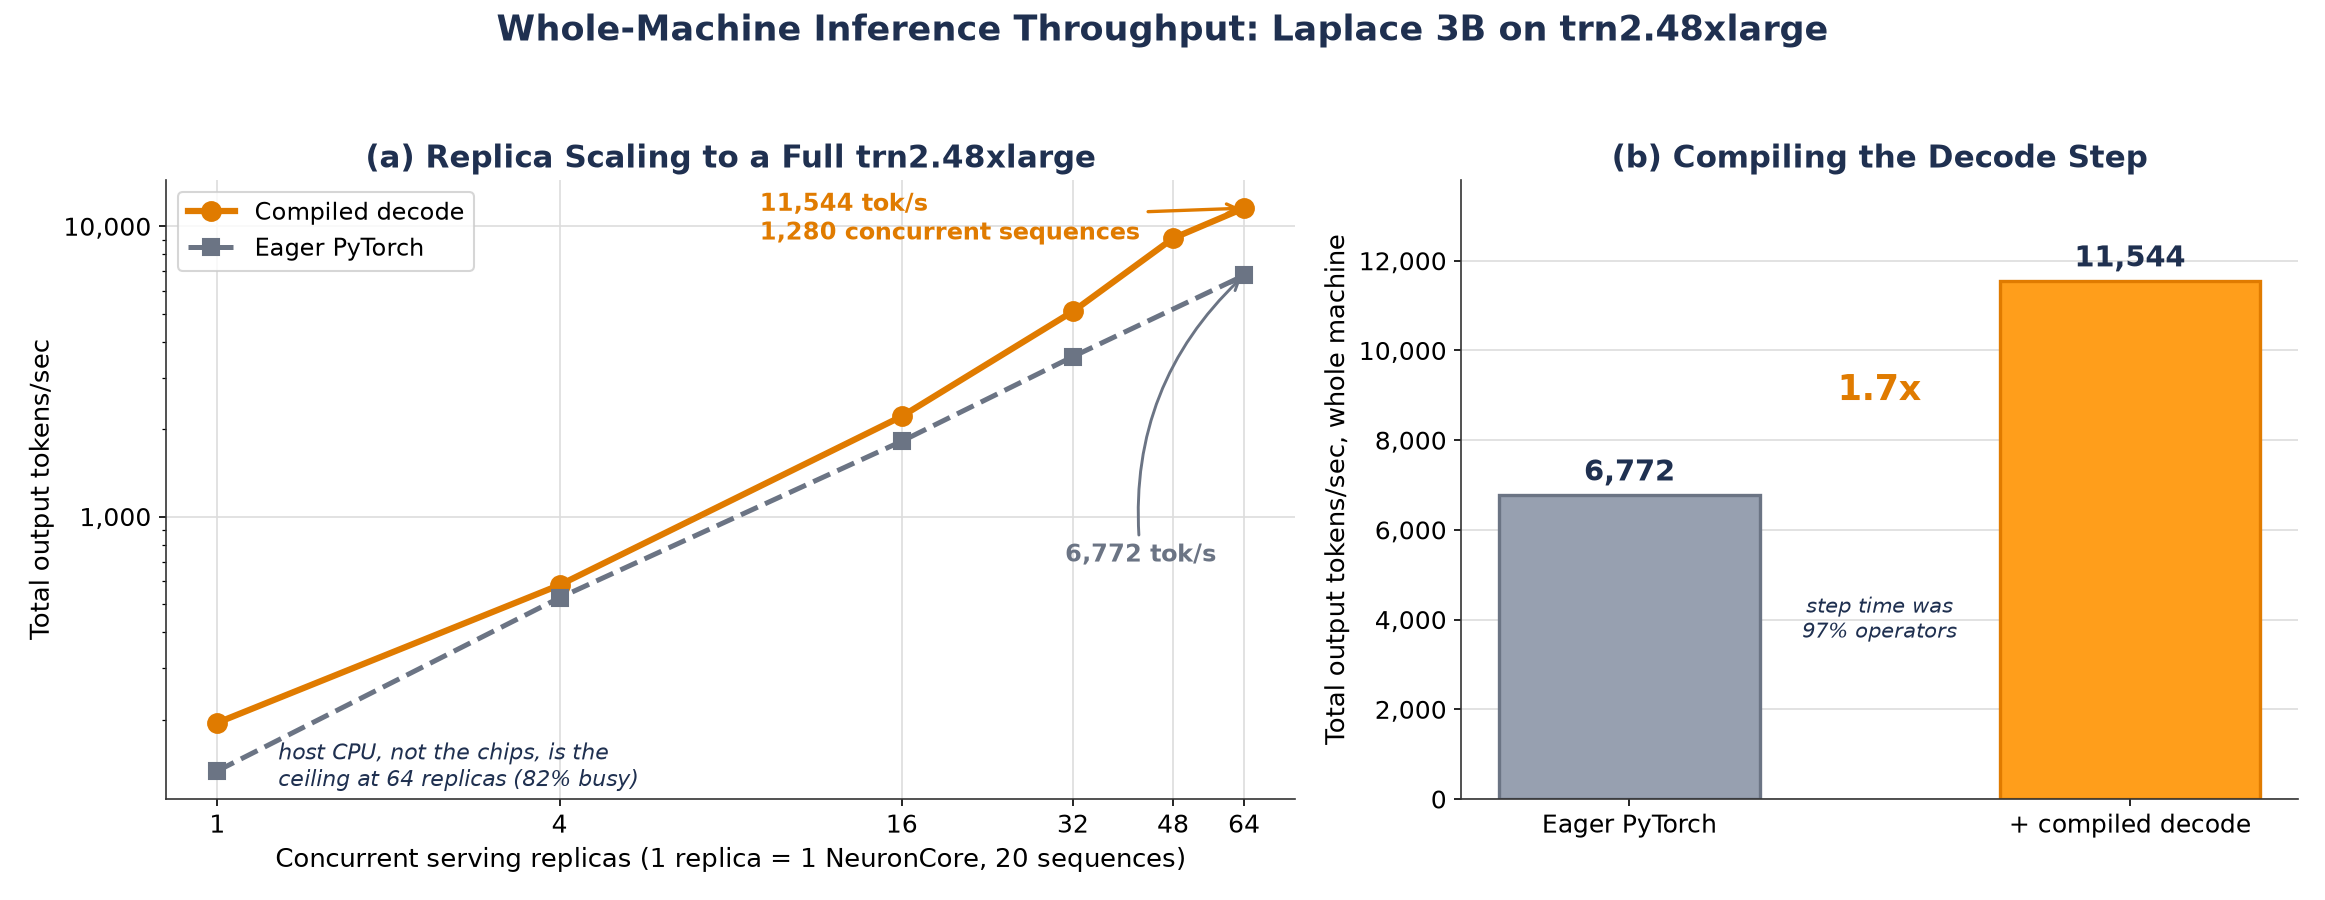
图 8:全实例推理吞吐量。(a) Eager 与编译解码下的副本扩展。(b) 编译解码将吞吐量从 6,772 提升到每秒 11,544 个输出 token。
固定批次基准测试所隐藏的问题。 在真实流量下,每个新的解码批次宽度都是一个单独编译的形状,其首次使用成本约为 11 秒。这些步骤仅占总量的 1.1%,却消耗了 47.5% 的解码时间。填充到固定宽度消除了这一成本,且结果逐位一致。在错峰到达的情况下,编译解码将每副本吞吐量提升了 3.52 倍,而在固定批次上仅提升 1.46 倍。由于 BF16 的重结合会使编译输出与 eager 略有不同,当需要精确可复现性时请使用 eager 解码。
关键要点
该项目在训练和推理两方面都得出了经验:
- 原生 PyTorch 可以在 Trainium2 上支持自定义架构。 i14 保留了 GLA 架构,并使用 TorchNeuron Native 进行最终实现。
- 通信设计对自定义优化器很重要。 Muon all_to_all 设计将每 rank 流量减少了 24 倍,并将训练吞吐量提升了 1.63 倍。
- 固定状态使推理内存可预测。 无论上下文长度如何,每个序列都使用 29.5 MB。
- 编译前先做性能分析。 解码时间的大部分来自算子调度,而非算术或 HBM 带宽。
- 对真实到达模式进行基准测试。 固定批次掩盖了为变化的批次宽度编译新形状的成本。
结论
Laplace 3B 表明 AWS Trainium2 可以支持标准 transformer 之外的模型架构。i14 通过 TorchNeuron Native 和 AWS Neuron SDK 使用原生 PyTorch,在训练和提供其基于 GLA 的模型服务的同时,保持了固定的循环状态。
对于智能体系统而言,这改变了一个基本的服务约束。更长的历史记录不需要更大的每序列状态,这可以帮助团队在保持内存使用可预测的同时保留更多上下文。
如果不断增长的上下文正在增加服务成本、降低并发度或限制智能体记忆,请尝试 i14,或联系您的 AWS 客户团队,在 AWS Trainium2 上评估 Laplace 3B。
资源
- 试用 i14
- AWS Trainium 和 Trainium2
- AWS Neuron SDK 文档
- 通过 TorchNeuron Native 在 AWS Trainium 上支持原生 PyTorch
- 具有硬件高效训练的门控线性注意力 Transformer
- Muon 优化器参考实现
- AWS 生成式 AI 创新中心
关于作者

Kevin Shabahang
Kevin 是 i14 的 AI 研究副总裁,在那里研究不同的模型架构。他的工作核心是应用认知科学和计算神经科学的洞见,开发更高效的大型语言模型。

Massimo Bardetti
Massimo 是 AI 研究初创公司 i14.ai 的 CTO。他曾在 Amazon Web Services、Microsoft 以及 AI、神经技术和娱乐领域的初创公司领导工程团队。他还创作互动艺术装置,并在世界各地的艺术节上展出。

Iman Abbasnejad
Iman 是 AWS 的应用科学家,与客户合作设计、开发和部署生成式 AI 解决方案。他的工作连接 AI 研究与实际应用,专注于大语言模型、智能体 AI 系统、模型微调和性能优化,以在 AWS 上构建可靠、高效且经济高效的 AI 解决方案。

Xiaodong Yu
Xiaodong 是 AWS 的机器学习工程师,专注于生成式 AI、大语言模型和机器学习性能优化。他的工作涵盖在 AWS 专用机器学习加速器(包括 AWS Trainium)上进行高效训练和推理。

Daniel Wirjo
Daniel 是 AWS 的解决方案架构师,专注于 AI 和 SaaS 初创公司。作为曾经的初创公司 CTO,他与创始人和工程负责人合作,在 AWS 上构建和发展业务。工作之余,Daniel 喜欢带着咖啡散步、亲近自然以及学习新想法。
来源:AWS Machine Learning Blog · aws.amazon.com