多智能体系统的 5 个生产挑战,以及 Deep Insight 如何解决
5 production challenges in multi-agent systems and how Deep Insight solved them
AWS 解决方案架构团队开源了多智能体系统 Deep Insight,用 Coordinator、Planner、Supervisor、Coder、Validator、Reporter、Tracker 等智能体把 CSV 数据加自然语言提示转成带引用的 .docx 分析报告。
AWS 团队拆解自家多智能体系统 Deep Insight 的五层生产架构,含模型分工与代码执行隔离的具体取舍。
现在构建多智能体系统已经相当简单了。真正的挑战始于将其投入生产环境。借助开源框架和云服务,你可以在几天内搭建出一个智能体。几次工具调用、几行提示词,就能做出看起来很不错的东西。但一旦团队试图从试点走向真实的业务应用,就会撞上一堵熟悉的墙。如果你曾经尝试过把智能体投入生产,这些挫败感听起来一定不陌生:
为什么智能体不遵循我们的业务逻辑、跳过验证步骤,或者捕捉不到边缘情况?
你调整提示词、增加更多示例、更换模型。同样的问题却反复出现。这是因为智能体并不遵循固定的指令序列。它们会根据上下文自行做出判断。仅靠指令是不够的。你需要设计智能体如何思考、何时进行验证,以及出错时该做什么。这正是为什么仅仅停留在提示词工程已经不够,而必须设计智能体的整个认知架构和执行流程,这一点变得至关重要。
为了正面应对这些挑战,AWS 解决方案架构团队构建了 Deep Insight,一个生产级的多智能体系统。在本系列文章中,我们将通过三篇文章分享团队在构建 Deep Insight 过程中的第一手经验。我们将介绍我们如何在真实生产环境中应用 Anthropic 提出的上下文工程(Context Engineering)技术(多智能体架构、结构化笔记、人在回路等)。我们还会介绍在此过程中遇到的权衡取舍(附代码),以及我们在 AWS 上部署和运行该智能体所获得的运维洞察。
博客系列概览
- 第 1 部分:多智能体系统中的 5 个生产挑战,以及 Deep Insight 如何解决它们。
- 第 2 部分:超越上下文窗口:上下文工程技术与 Deep Insight 如何应用它们。
- 第 3 部分:实践中的驾驭工程:将 Deep Insight 从开发推向生产。
这是三部分系列文章的第 1 部分。它定义了任何生产级多智能体系统都必须解决的五个核心挑战,并展示了技术栈的每一层如何应对这些挑战,从 Strands Agents SDK 和 Amazon Bedrock,到 Amazon Bedrock AgentCore、Application Load Balancer 和 AWS Fargate。第 2 部分和第 3 部分将介绍上下文工程和生产部署。
Deep Insight 简介
Deep Insight 是一个多智能体系统,可将复杂的数据分析转化为自动化洞察。给定一个 CSV 文件和一段自然语言提示词,由专业化智能体组成的层级结构(Coordinator、Planner、Supervisor、Coder、Validator、Reporter 和 Tracker)会协作完成分析。它们共同加载数据、运行分析、生成图表、验证计算,并生成带有引用的专业报告(.docx)。
我们稍后会详细探讨其架构。首先,让我们看看它的实际运行效果。在演示中,我们输入来自一家虚构食品公司 Yummy Food 的广告数据(yummy-food-market.csv)以及一个列定义文件(column_definitions.json),并提供提示词:从销售和营销的角度分析这些数据,生成图表和洞察,并生成一份 .docx 报告。Deep Insight 会生成一份分析计划,将其呈现给用户审批,一旦获批,便执行分析。
| 内容 | |
| 输入 | CSV 数据文件(yummy-food-market.csv)+ 列定义文件(column_definitions.json) |
| 示例提示词 | “从销售和营销的角度分析这一点,生成图表和洞察,并生成一份 .docx 报告。” |
| 输出 | DOCX 报告(两个版本,一个带引用,一个不带引用)以及图表图形(PNG) |
接下来的 Deep Insight Web 演示视频 展示了完整工作流程,从上传数据和查看分析计划到实时流式传输和下载完成的报告。
我如何试用它?
Deep Insight 已在 GitHub 上开源,并附有完整的设置指南,提供三种部署选项,涵盖从开发到生产的各个阶段。
第一种是 自托管版本,通过 CLI 在本地运行。它针对快速迭代进行了优化,可对每个 agent、提示词和工作流进行完整的代码级访问。它大约 10 分钟即可完成设置,因此非常适合开发。(YouTube 上提供了自托管演示视频。)
第二种是 Web 版本,这是一个基于浏览器的 UI,用于上传数据、查看分析计划(Human-in-the-Loop,即 HITL)以及下载报告,全程无需编写代码,因此非开发者也能使用。(前面的演示视频展示了 Web 版本的实际运行情况。)
第三种是 托管 AgentCore 版本,这是一种由 Amazon Bedrock AgentCore 提供支持的生产部署选项,该平台可用于大规模构建、连接和优化 agent,并支持任何框架或模型。此版本将 agent 部署在 AgentCore runtime 上,这是 Amazon Bedrock AgentCore 的一项能力。系统完全在私有虚拟私有云(VPC)内运行,自定义 Code Interpreter 单独托管在 AWS Fargate 上,agent 在隔离的每用户环境中并发运行。当你需要会话隔离和私有 VPC 部署时,这是合适的选择。第 3 部分详细介绍了其部署和运维。
这三种版本共享相同的多 agent 架构,因此在开发中验证过的 agent 可以原样部署到生产环境。
解决方案概述
构建生产级多 agent 系统不仅仅需要好的提示词。你需要合适的技术栈和基础设施,来解决 agent 如何协作、如何推理、如何部署、在哪里安全执行代码以及如何监控运行健康状况等问题。Deep Insight 解决了这五个关键领域中的问题。由于 agent 既生成代码又生成报告内容,我们还在解决方案详情 2 中介绍了生产环境中的负责任 AI 控制措施。
| 挑战 | 技术 | 方法 |
| “我们如何控制多个 agent 之间的执行流程?” | Strands Agents SDK | 使用 Strands 的 Graph 模式定义 agent 之间的执行顺序,并实现 human-in-the-loop 分支。使用 Strands 的 Agents as Tools 模式,使 Supervisor 能够按需将专用 agent(Coder、Validator、Reporter、Tracker)作为工具调用。 |
| “每个 agent 应使用哪个大语言模型(LLM)?” | Amazon Bedrock | 为每个角色选择合适的 Claude 模型:Haiku 用于基本路由,Opus 用于规划,Sonnet 用于执行。 |
| “我们如何可靠地在生产环境中运行已完成的 agent?” | Amazon Bedrock AgentCore | 具有监控、会话隔离和私有 VPC 部署的托管运行时。 |
| “我们如何缓解执行 AI 生成代码的安全问题?” | AWS Fargate + Application Load Balancer (ALB) | 通过自定义 Code Interpreter,为每个会话提供临时沙箱容器,以实现隔离的代码执行。 |
| “我们如何监控和管理系统?” | Amazon DynamoDB + Amazon Simple Notification Service (Amazon SNS) + Amazon Cognito | 管理仪表盘与故障告警系统。 |
以下架构图(图 1)可让您一目了然地了解这一点。绿色方框代表 Strands Agents 多智能体结构,它解决了上表中的挑战 1 和挑战 2。我们将在接下来的“解决方案详情 1:多智能体系统设计”部分中详细介绍。图中展示的其余基础设施组件解决了挑战 3、4 和 5,我们将在“解决方案详情 2:生产部署与运维”中逐一说明。
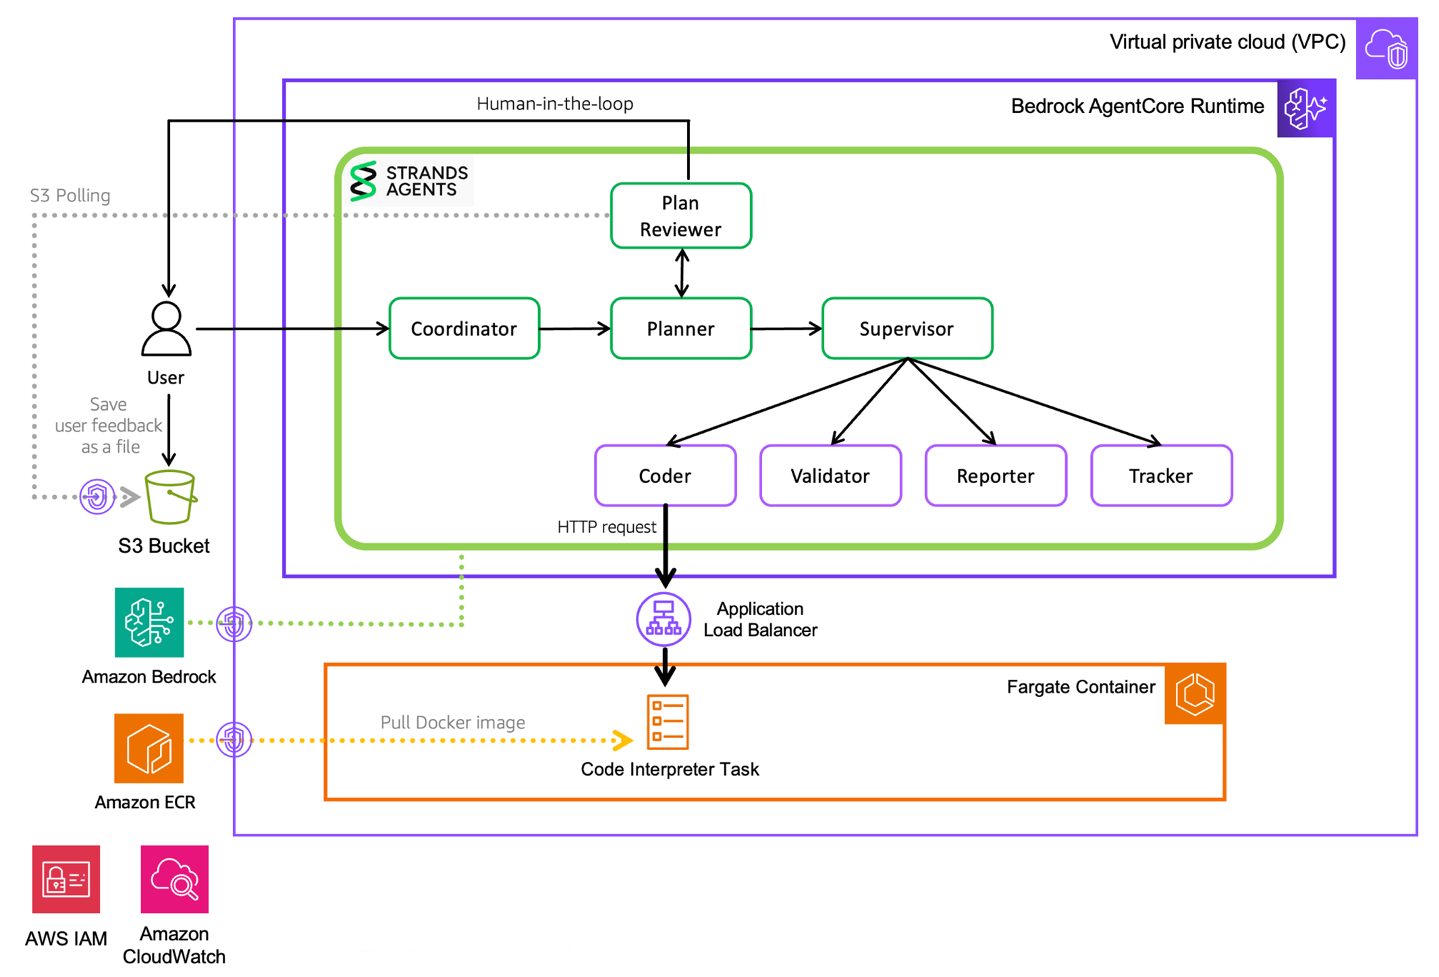
图 1:解决方案架构
解决方案详情 1:多智能体系统设计
Deep Insight 采用多智能体架构,由八个智能体协作产出一份高质量的交付成果。每个智能体都在各自独立的上下文中工作,只执行自己的专门任务,并且只向下游传递压缩后的结果。
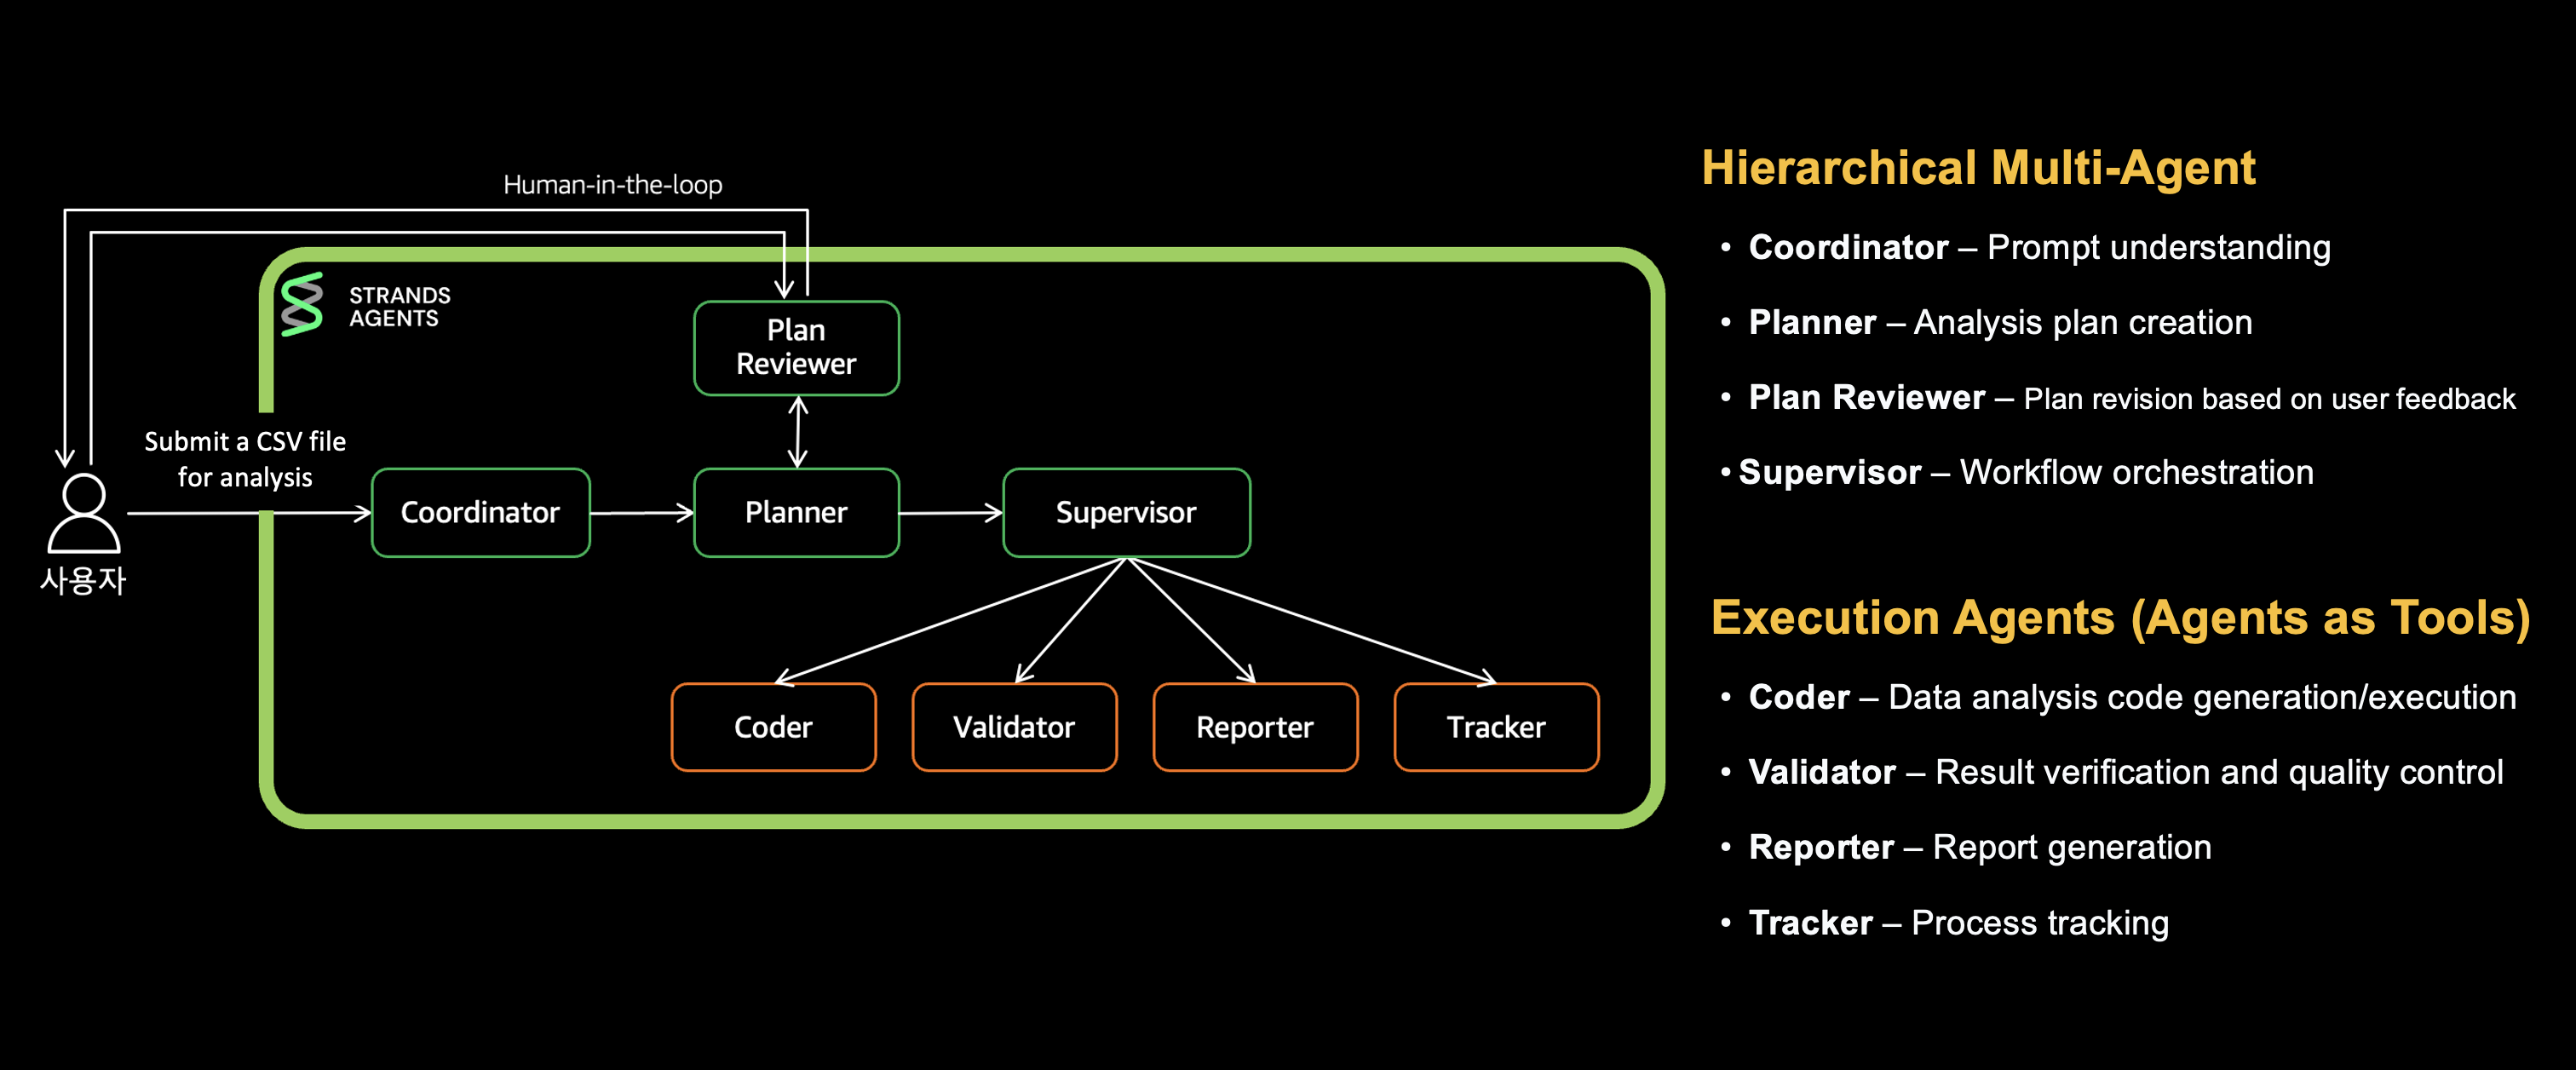
图 2:多智能体结构
Coordinator 负责路由用户请求,Planner 将任务拆解为离散步骤,Plan Reviewer 收集用户反馈,Supervisor 则根据计划调用相应的专门智能体。Coder 编写并执行数据分析代码,Validator 校验计算,Reporter 生成最终报告,Tracker 跟踪进度。我们将分三层进行说明:
- [第 1 层] Coordinator 到 Planner 到 Plan Reviewer:请求分析与执行计划创建。
- [第 2 层] Supervisor:专门智能体编排。
- [第 3 层] Coder、Validator、Reporter、Tracker:专门任务执行。
我们结合 Strands Agents SDK 中的两个关键模式来控制这些智能体之间的执行流程。第一,Graph 模式以有向图的形式定义智能体的执行顺序和流程。请求依次流经 Coordinator、Planner、Plan Reviewer,然后到达 Supervisor,并在收到修订请求时通过条件分支循环回 Planner。通过条件决定下一步,使 HITL 和错误处理等复杂工作流变得简单直接。第二,Agents-as-Tools 模式让 Supervisor 仅在需要时将专门智能体(Coder、Validator、Reporter、Tracker)作为工具调用。每个智能体都在独立上下文中工作,只返回结果,从而在保留领域专业知识的同时最大限度地减少上下文占用。
本节展示该架构如何解决路由、规划和编排问题。
[第 1 层] Coordinator 到 Planner 到 Plan Reviewer
这一层将用户请求转化为一份获批的执行计划。
1.1 Coordinator(路由):并非每个请求都需要昂贵的编排
Coordinator 是用户请求的入口。它直接处理基本问候语,并通过 handoff_to_planner 标记将数据分析等复杂任务路由给 Planner。
关键的设计决策是模型选择:由于 Coordinator 只进行分类,它使用轻量级的 Claude Haiku,避免在基本问候上产生 Opus 级别的成本,并实现快速响应。
# builder.py: conditional edges for routing decisions
builder.set_entry_point("coordinator")
builder.add_edge("coordinator", "planner", condition=should_handoff_to_planner)
路由条件来自 Coordinator 的提示词:任何需要工具、推理或多步思考的请求都会交给 Planner。
1.2 Planner(计划创建):复杂分析需要先分解再执行
在 Deep Insight 的多智能体结构中,Planner 智能体承担着在各智能体之间分配任务的关键角色。在实质性工作开始之前,它会把大任务拆解为更小的步骤,由各个专用智能体逐一执行,从而让每个智能体的上下文保持较小规模。
Planner 使用开启了 Extended Thinking 的 Claude Opus 模型来制定分析计划。它把计划组织成 [ ] 清单格式,其中明确列出分配给每个智能体的具体任务,并存储在 full_plan 变量中。它把请求拆解为 5–10 个清晰的步骤,如下例所示:
## title
Yummy Food Consumer Purchase Patterns and Advertising Effectiveness Analysis Report

## steps

### 1. Coder: Comprehensive Data Analysis and Insight Generation
- [ ] Load all data files from './data/*' path and understand structure
- [ ] Analyze consumer purchase history (patterns, preferences, customer segments)
- [ ] Analyze advertising data by channel (cost, effectiveness, channel comparison)
- [ ] Category-level analysis (fresh food, convenience food, health food ad effectiveness)
- [ ] Calculate key business metrics (conversion rate, CPA, ROAS, etc.)
- [ ] Generate visualizations (5+ charts, consumer segment charts)
- [ ] Derive strategic marketing insights
- [ ] Generate calculation metadata (for validation)

### 2. Validator: Calculation Verification and Citation Metadata Generation
- [ ] Identify verification targets and extract filter calculations
- [ ] Load data files directly and perform recalculations
- [ ] Verify accuracy of per-channel performance metrics
- [ ] Validate data consistency of visuals and graphs
- [ ] Generate citation metadata (reference numbers for verified items)

### 3. Reporter: Marketing Analysis Report Generation
- [ ] Write report overview
- [ ] Create structured report using verified analysis results
- [ ] Insert visualizations and analysis sections
- [ ] Present marketing strategy recommendations and improvement proposals
- [ ] Generate professional marketing report in DOCX format
1.3 计划审核器
计划审核器是一个 HITL 节点,它把计划呈现给用户,并收集批准或修订反馈。如果有反馈,它会回到 Planner 修订计划。如果获得批准,它就把任务交给 Supervisor。设置了最大修订次数(MAX_PLAN_REVISIONS)以防止无限循环。
# builder.py: Plan Reviewer's bidirectional conditional edges
builder.add_edge("plan_reviewer", "planner", condition=should_revise_plan)
builder.add_edge("plan_reviewer", "supervisor", condition=should_proceed_to_supervisor)
builder.set_max_node_executions(25)
在 Web 版本中,计划审核器会显示一个浏览器模态框,用户可以在其中阅读计划并批准它或输入修订反馈。如果 300 秒内没有响应,倒计时结束会自动批准该计划。
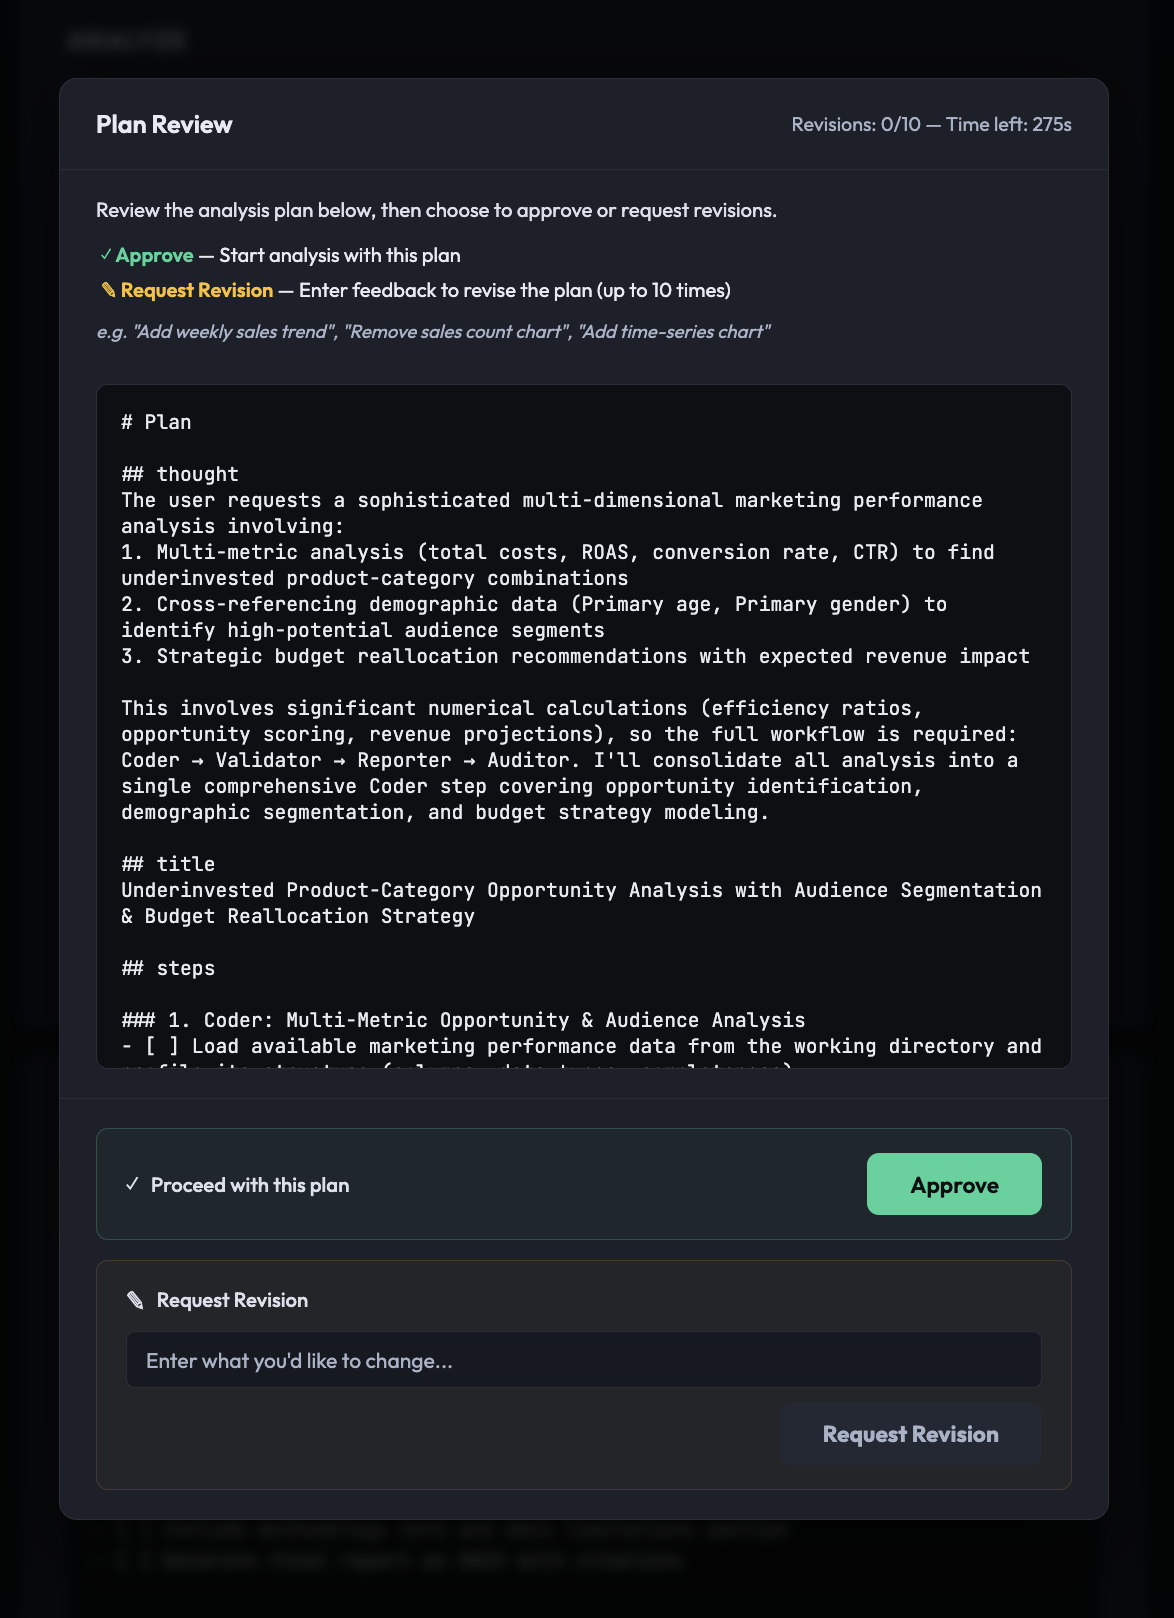
图 3:Web UI 中计划审核器智能体的执行过程
如果没有规划,智能体就会在运行时决定一切,中途修正会使先前的工作失效,而且用户无法了解进度。有了 Planner 和计划审核器,用户可以审核和修订计划、实时监控进度,并且只重新执行失败的步骤。
[第二层] Supervisor(编排器):专用智能体需要一位指挥
Supervisor 按顺序执行 Planner 的 full_plan,通过 Tool Use 调用注册在其上的第三层智能体(Coder、Validator、Reporter、Tracker)作为工具。
# nodes.py: registering sub-agents as tools on the Supervisor
agent = strands_utils.get_agent(
    agent_name="supervisor",
    system_prompts=apply_prompt_template(prompt_name="supervisor", prompt_context={}),
    model_id=os.getenv("SUPERVISOR_MODEL_ID", os.getenv("DEFAULT_MODEL_ID")),
    prompt_cache_info=(True, "default"),
    tool_cache=True,
    tools=[coder_agent_tool, reporter_agent_tool, tracker_agent_tool, validator_agent_tool],
    streaming=True,
)
Supervisor 的系统提示词定义了严格的工作流规则:
- 强制执行顺序:Coder、Tracker、Validator、Tracker、Reporter、Tracker:每个智能体运行后,都会调用 Tracker 来跟踪进度,让 Supervisor 管理整体任务状态。
- 章节完成规则:在当前智能体的所有清单项都标记为 [x] 之前,Supervisor 不会进入下一个智能体。
- 上下文保留:Supervisor 把 clues 和 full_plan 变量传递给每个工具智能体,保持完整上下文并防止信息丢失。
[第三层] Coder、Validator、Reporter、Tracker:分工驱动质量
每个第三层智能体(Coder、Validator、Reporter、Tracker)都被包装为 PythonAgentTool,并接收来自 Supervisor 的 Tool Use 调用。每个智能体都在 Strands SDK 中创建为独立的 Agent() 实例,拥有自己的系统提示词、模型 ID 和工具集。
| 智能体 | 角色 | 工具 | 关键输出 |
| Coder | 数据分析、图表生成、洞察推导 | write_and_execute_tool、bash_tool、file_read、skill_tool | *.png 图表、calculation_metadata.json |
| Validator | 数值计算复核、引用生成 | write_and_execute_tool、bash_tool、file_read | citations.json、validation_report.txt |
| Reporter | DOCX 报告生成 | write_and_execute_tool、bash_tool、file_read | final_report.docx、final_report_with_citations.docx |
| Tracker | 清单进度状态更新 | 无(仅 LLM 推理) | 更新后的 full_plan |
Supervisor 根据 Planner 的清单,按以下顺序发起 Tool Use 调用:
- Coder – 加载数据、编写并运行分析代码、生成 PNG 图表、将结果累积到 all_results.txt,并留下
calculation_metadata.json供验证。 - Tracker(第一轮)– 将已完成的清单项从 [ ] 更新为 [x],Supervisor 据此决定是否继续。
- Validator – 基于源数据重新执行
calculation_metadata.json中的每一项计算。误差在 0.01 以内即通过,不匹配则标记出来。已验证的计算结果会送入citations.json,供 Reporter 引用。 - Tracker(第二遍)– 在检查清单中反映 Validator 的完成状态。
- Reporter – 读取 all_results.txt 和
citations.json,生成最终 DOCX 报告的两个版本:带引用和不带引用。 - Tracker(第三遍)– 反映所有任务的最终完成状态。
Tracker 在每个 agent 之后运行,以便 Supervisor 跟踪进度并执行完成规则(在所有条目都标记为 [x] 之前不得继续推进)。由于它依靠 LLM 推理更新检查清单且不使用工具,因此带来的额外开销很小。
各 agent 的 LLM 模型配置
Deep Insight 会针对每个 agent 的角色定制模型和设置。这不是模型选型,而是一项为优化成本与质量而做出的架构决策。
| Agent | 模型 | 扩展思考 | 提示缓存 | 角色 |
| Coordinator | Haiku | 禁用 | 否 | 快速路由:成本最小化 |
| Planner | Opus | 启用(约 8,192 tokens) | 否 | 深度思考:高质量规划 |
| Supervisor | Sonnet | 禁用 | 是 | 执行编排:通过缓存节省成本 |
| Coder | Sonnet | 禁用 | 是 | 代码生成/执行:缓存对重复调用有效 |
| Validator | Sonnet | 禁用 | 否 | 数值验证:每次数据不同,缓存无必要 |
| Reporter | Sonnet | 禁用 | 是 | 报告生成:缓存对长提示有效 |
| Tracker | Sonnet | 禁用 | 否 | 状态更新:轻量任务,缓存无必要 |
Supervisor、Coder 和 Reporter 这三个 agent 使用提示缓存来缓存各自的系统提示和工具定义,从而在重复调用时将输入 token 成本最多降低 90%。Coordinator 只运行一次,而 Validator 和 Tracker 每次运行时上下文都不同,因此缓存对它们无效,保持禁用。这种选择性缓存策略是有意为之的成本/性能权衡。
解决方案细节 2:生产部署与运维
如果说解决方案细节 1 定义了系统做什么,那么本节则定义它在何处以及如何安全运行。从这里开始,内容都涉及生产运维的基础设施决策。具体而言,本节涵盖 LLM 生成代码的安全执行环境,以及团队所需的运维可见性。
1. 代码执行:LLM 生成的代码需要安全的执行环境
Coder 智能体编写并运行 Python 进行数据分析。在自托管版本中,它通过 subprocess.run() 在本地运行,但在生产环境(AgentCore)中,安全性和隔离性至关重要。在生产服务器上直接运行 LLM 生成的代码存在风险:模型可能会删除系统文件、在无限循环中耗尽资源,或访问其他用户的分析数据。Deep Insight 通过在 AWS Fargate 和 ALB 上为每个会话提供临时容器来解决这一问题。这些组件并非孤立运行。如图 1 所示,AgentCore 运行时、ALB 和 Fargate 任务都运行在同一个私有 VPC 内。VPC 端点将它们连接到 Amazon Simple Storage Service(Amazon S3)、Amazon Bedrock 和 Amazon Elastic Container Registry(Amazon ECR),而无需经过公共互联网。安全组限制哪些组件可以访问 Code Interpreter 容器。AWS Identity and Access Management(IAM)角色将每个组件的权限限定为其所需的 AWS 资源。Amazon CloudWatch 从 AgentCore Observability(Amazon Bedrock AgentCore 的一项能力)收集容器日志和可观测性数据。
- 自定义容器 Docker 镜像:一个预先优化的沙箱,包含多智能体系统所需的字体、系统库和 Python 包。
- 容器隔离:每个分析会话在私有 VPC 子网中获得一个独立的 Fargate 容器,且无法直接访问互联网。
- 两步执行:LLM 生成的代码经 base64 编码后通过 HTTP 发送,写入文件(第 1 步),然后通过子进程执行(第 2 步)。
- 会话亲和性:ALB 粘性会话 Cookie 将智能体路由回同一个容器,即使它多次执行代码也是如此。
- 产物管理:分析完成后,图表、报告和日志上传到 Amazon S3。容器在一小时后自动终止。
容器隔离保护了基础设施,但并不能管控智能体生成的内容。Validator 智能体重新验证计算。它不会检测上传数据中隐藏的提示注入指令,也不会筛查 LLM 生成的文本中是否存在有害或无依据的内容。对于生产部署,我们建议添加 Amazon Bedrock Guardrails 作为负责任的 AI 控制措施:对用户提示和上传数据应用内容过滤器和提示攻击检测,并对智能体输出应用上下文接地检查,使报告文本始终基于源数据和经过验证的计算。
2. 运维与监控:团队需要可见性
仅靠代码无法构成完整的生产系统。团队必须评估系统健康状况、诊断问题并审查结果,因此 Deep Insight 提供了 Web UI 和运维仪表盘。
Web UI(deep-insight-web)
一个基于 FastAPI 的 Web 界面,通过 AgentCore Native Protocol(boto3.invoke_agent_runtime())与后端通信。用户上传数据并输入提示,然后通过 Server-Sent Events(SSE)流式传输监控进度。当计划生成后,弹窗允许用户批准或提供修改反馈(HITL)。完成的报告可直接下载。支持韩语和英语。
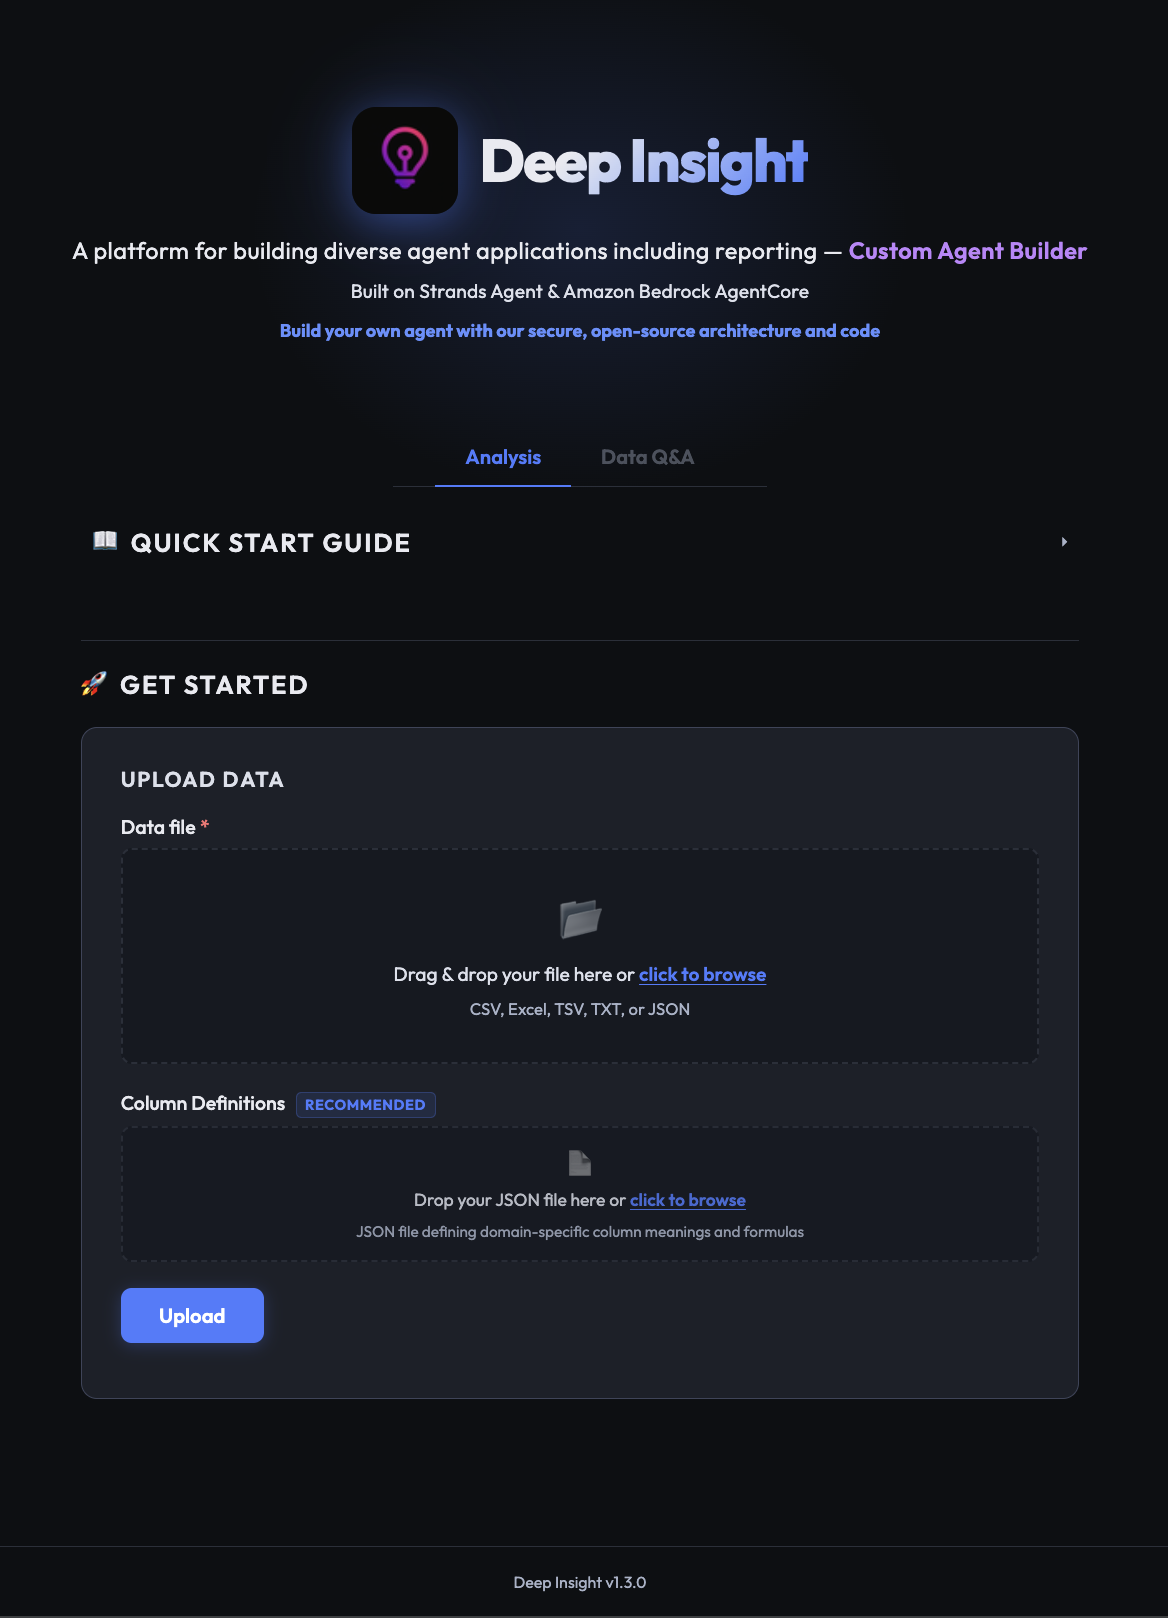
图 4:Deep Insight Web 版截图
运维仪表盘(deep-insight-web/ops)
运维仪表盘是可选的。没有它 Deep Insight 也能正常运行,但它为有需要的团队增加了以下功能:
- 任务跟踪:所有分析任务指标,包括状态、token 使用量和耗时,都记录在 Amazon DynamoDB 中。
- 故障告警:当分析失败时,立即通过 Amazon SNS 向管理员发送电子邮件。
- 管理仪表盘:专用管理仪表盘通过 Amazon Cognito 的 JSON Web Token (JWT) 身份验证进行保护,以实现安全的任务监控。
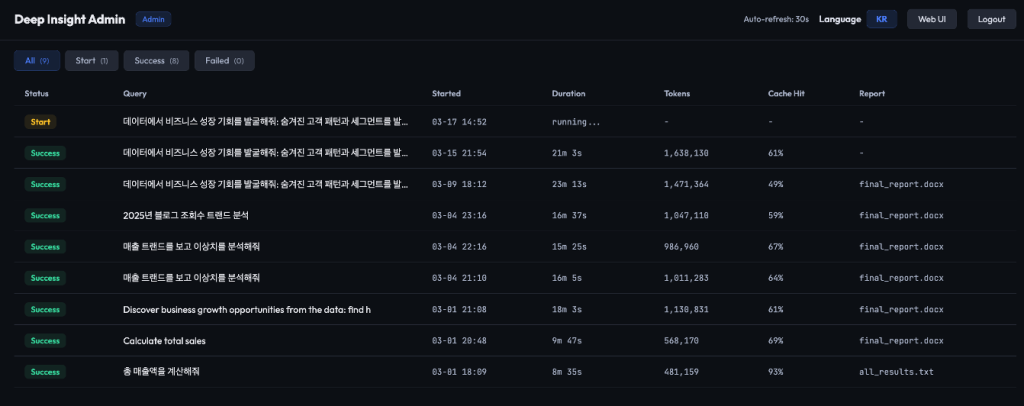
图 5:Deep Insight Ops 仪表盘截图
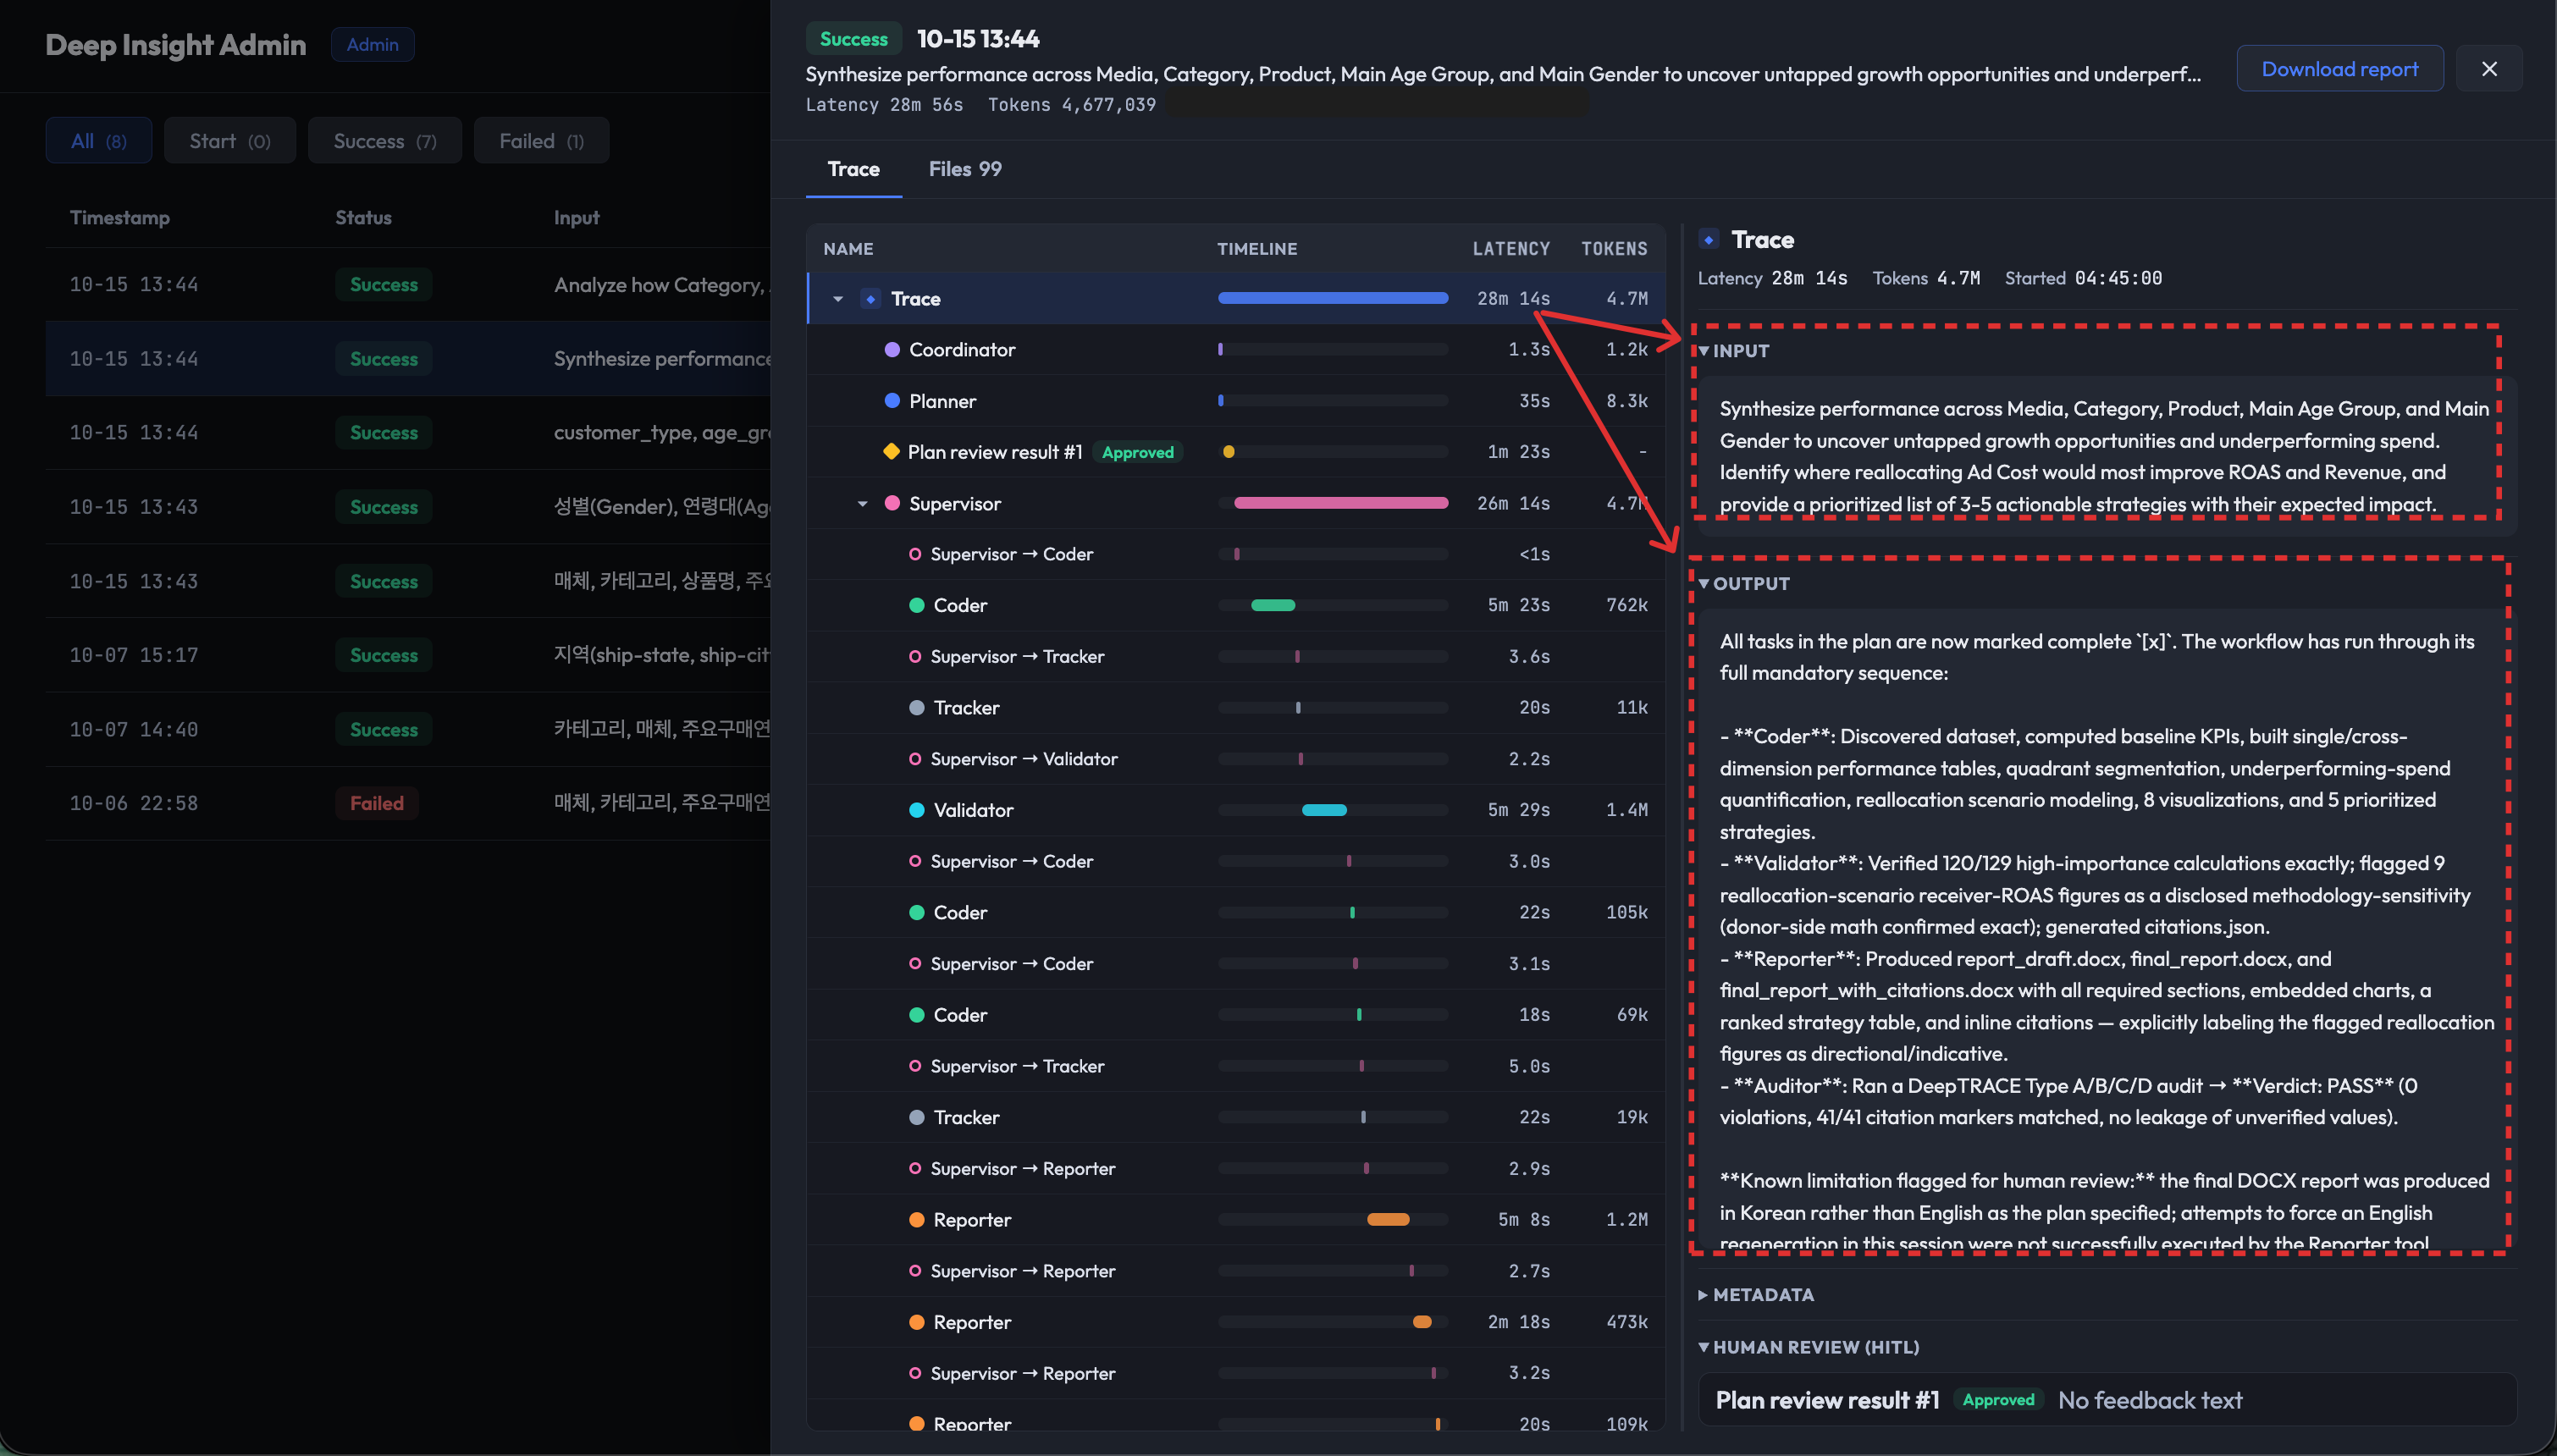
图 6:Deep Insight Ops 仪表盘详情视图
扩展 Deep Insight 架构
Deep Insight 的多智能体架构并不局限于数据分析报告生成这一单一领域。以下两个示例表明,分层编排的设计原则在完全不同的领域依然有效。
案例 1:LG Electronics:由智能体 AI 驱动的营销洞察提取系统
LG Electronics 韩国销售部门基于与 Deep Insight 相同的多智能体架构构建了 ChatInsight,此前数据分析请求需要 2–3 周,且营销人员与数据科学家之间的意图会在传递中丢失。Coordinator 按复杂度进行路由,Planner 跟踪任务,Supervisor 编排 Coder 和 Reporter,智能体之间的状态通过 all_results.txt 文件累积传递。原本需要 3 天的分析现在只需 30 分钟,生产力提升 288 倍。不懂 SQL 的营销人员可以让智能体探索数据并提出策略(参见 AWS 技术博客上的 LG Electronics 智能体 AI 洞察提取系统)。
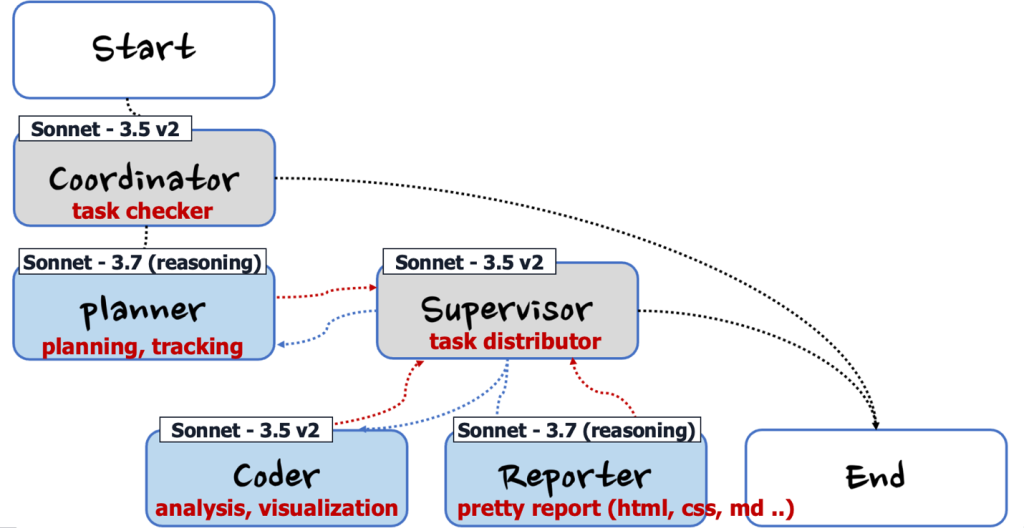
图 7:LG Electronics 智能体 AI 营销洞察系统架构
案例 2:TechRecon:AI 驱动的技术侦察智能体(re:Invent 2025)
TechRecon 在 AWS re:Invent 2025(会议 SNR203)上展示,将 Deep Insight 的架构应用于技术战略。给定一家公司和行业,Researcher 收集技术趋势,Coder 进行分析,Validator 进行验证,Reporter 生成格局分析和技术定位报告。该架构与 Deep Insight 几乎相同,使用 Strands Agents SDK 的 Graph 模式以及 Extended Thinking 和 Prompt Caching 构建,只是由 Researcher 取代 Coder 作为主要执行智能体。这表明该设计是一种通用模式:替换智能体的角色和提示词,相同的编排结构就能解决完全不同的问题。
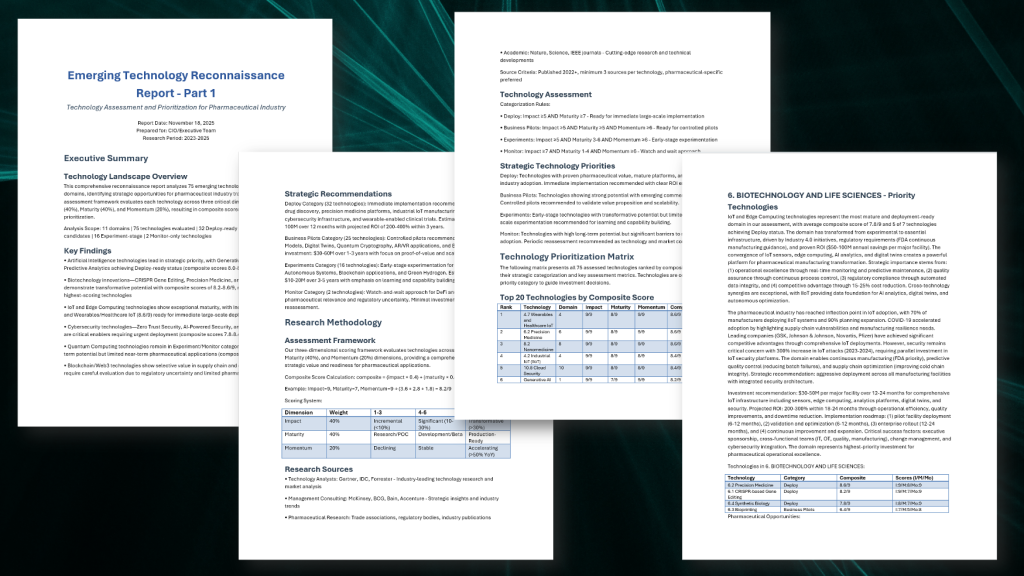
图 8:TechRecon 结果
(阅读更多:TechRecon GitHub | AWS re:Invent 会议视频)
结论
构建一个能在生产环境中运行的智能体,关键不在于模型能力,而在于架构。Deep Insight 提供了一个经过验证的答案:
- 工作流管理:Strands Agents SDK 的 Graph 模式定义智能体之间的执行顺序并实现 HITL 分支,而 Agents-as-Tools 模式让 Supervisor 仅在需要时调用专用智能体。
- 推理引擎:我们按角色分配 Amazon Bedrock 中的 Claude 模型(Haiku,然后 Opus,然后 Sonnet),以优化成本和质量。
- 部署:Amazon Bedrock AgentCore 提供具有会话隔离、私有 VPC 部署和 OpenTelemetry 可观测性的托管运行时。
- 代码执行:Application Load Balancer 加上 Amazon Elastic Container Service (Amazon ECS) on Fargate,在按会话创建的临时沙箱容器中隔离 LLM 生成的代码执行,防止系统文件访问、资源耗尽和意外数据泄露等安全问题。
- 运维:Web UI 的 SSE 流式传输和 Ops 仪表盘(DynamoDB + Cognito + SNS)为整个团队提供可见性。
LG Electronics 的营销洞察系统和 re:Invent 2025 上的 TechRecon 案例验证了这些设计原则。
在第 2 部分中,我们在此架构之上考察四层上下文工程技术,用于克服上下文窗口限制,从架构级隔离到提示设计、工具优化和验证保障,并将我们的方法与 Anthropic 的工程研究进行比较。
Deep Insight 是开源的。探索代码并将其扩展到您自己的领域。
关于作者

Yoonseo Kim
Yoonseo 是一名解决方案架构师,帮助客户使用 AWS 技术解决业务挑战。她对 AI/ML 有浓厚兴趣,专注于帮助客户设计和优化智能体 AI 工作负载,以及配套的基础设施和评估环境。

Jesam Kim
Jesam 是一名解决方案架构师,帮助企业客户采用云技术并解决业务挑战。他专注于 AI/ML,包括推荐系统和生成式 AI,帮助客户设计满足其业务需求的架构。

Jiyun Park
Jiyun 是一名解决方案架构师,帮助软件和互联网行业的客户将工作负载迁移到云端。她与客户合作设计云解决方案,帮助他们实现业务目标。

Kyutae Park
Kyutae 博士是一名 AI 专家解决方案架构师,帮助各行业的客户设计和构建应用型 AI 工作负载,凭借在机器学习、MLOps 和智能体 AI 方面的丰富经验。他专注于通过智能体 AI 实现智能自动化和运营创新,将自主决策和多智能体协作架构引入真实业务环境。通过这项工作,他帮助客户使用 AWS AI/ML 服务和应用型生成式 AI 实现切实的业务成果并构建可持续的竞争优势。

Gonsoo Moon
Gonsoo 是 AWS 的 AI/ML 专家解决方案架构师。凭借在多种 AI/ML 用例和生产部署方面的经验,他与客户紧密合作,解决他们的 AI/ML 挑战。他还与数据科学家、开发人员和分析师分享 AI/ML 知识,致力于为韩国和世界各地带来积极变化。

Chloe Kwak
Chloe 是 Amazon Web Services 韩国零售团队的高级解决方案架构师。她帮助韩国的零售和电子商务客户设计可扩展、经济高效的云架构,并采用 AI/ML 服务以加速其业务成果。
来源:AWS Machine Learning Blog · aws.amazon.com