Amazon SageMaker AI 多轮强化学习实操指南
Multi-Turn Reinforcement Learning on Amazon SageMaker AI: A hands-on guide
AWS 发布在 Amazon SageMaker AI 上做多轮强化学习(MTRL)的实操指南,训练任务通过 AgentCore 托管的智能体完成整局任务后只回传一个结果奖励,用 GRPO 更新 LoRA 适配器。
原文完整给出多轮强化学习的部署、训练与评测流程,并公开了奖励设计失误和成本数据,可作为同类任务的迁移参考。
大多数微调教模型针对单个提示生成更好的答案。智能体任务则不同。一个提交费用报告或分诊支持工单的智能体会执行一系列动作,每一步都取决于之前发生的事。很少有唯一正确的序列可供模仿,唯一可靠的反馈是整个序列是否成功。监督微调没有针对这一点的标签,而单轮强化学习无法将结果归因于三步之前做出的决策。
Amazon SageMaker AI 上的多轮强化学习(MTRL)正是基于这一信号来训练模型。SageMaker AI 通过 AWS Lambda 转发器将提示发送到你在 Amazon Bedrock AgentCore 上托管的智能体,或你自己的基础设施上,例如 Amazon Elastic Kubernetes Service(Amazon EKS)、Amazon Elastic Compute Cloud(Amazon EC2)或 AWS Fargate。此处的示例使用 AgentCore。智能体调用正在训练的策略模型,在任务所需的任意多轮中在你的环境中行动,并在回合结束时报告一个奖励。你无需指定正确的轨迹,只需指定如何对结果评分。
本文以 Wordle 为例,这是一款玩家有六次机会猜出一个隐藏的五字母单词的游戏。每次猜测后,每个字母若位置正确则变绿,若在单词中但位置不同则变黄,若不在单词中则变灰。这款游戏适合 MTRL,因为规则很少,每次猜测都取决于上一次的反馈,且结果可以客观评分。Wordle 只是一个教学示例,前沿模型已经能玩得很好。在实践中,你会用 MTRL 让一个小型、低成本模型擅长某项特定于你业务的多步任务,例如公共模型从未训练过的内部工作流。同样的流水线也适用于这种场景。
在我们的运行中,MTRL 将 gpt-oss-20b 在默认推理强度下对留出单词的解决率从 61% 提升到 84%,在其训练所用的低推理强度下从 15% 提升到 69%,训练 token 成本约为 339 美元。本文中,我们端到端地走一遍整个流水线:将智能体和奖励部署到 AgentCore、准备数据集、训练、在 MLflow 中监控,以及在服务设置下评估。我们还会分享我们遇到的奖励设计错误和训练失败。你的数据集、智能体和训练后的模型保留在你的 AWS 账户中,不会被用于训练基础模型。所有代码都在配套的 aws-samples 仓库中。
解决方案概览
该系统分为两半。SageMaker AI 负责训练作业和策略模型。AgentCore 托管智能体、Wordle 环境和奖励函数。下图展示了它们如何连接。
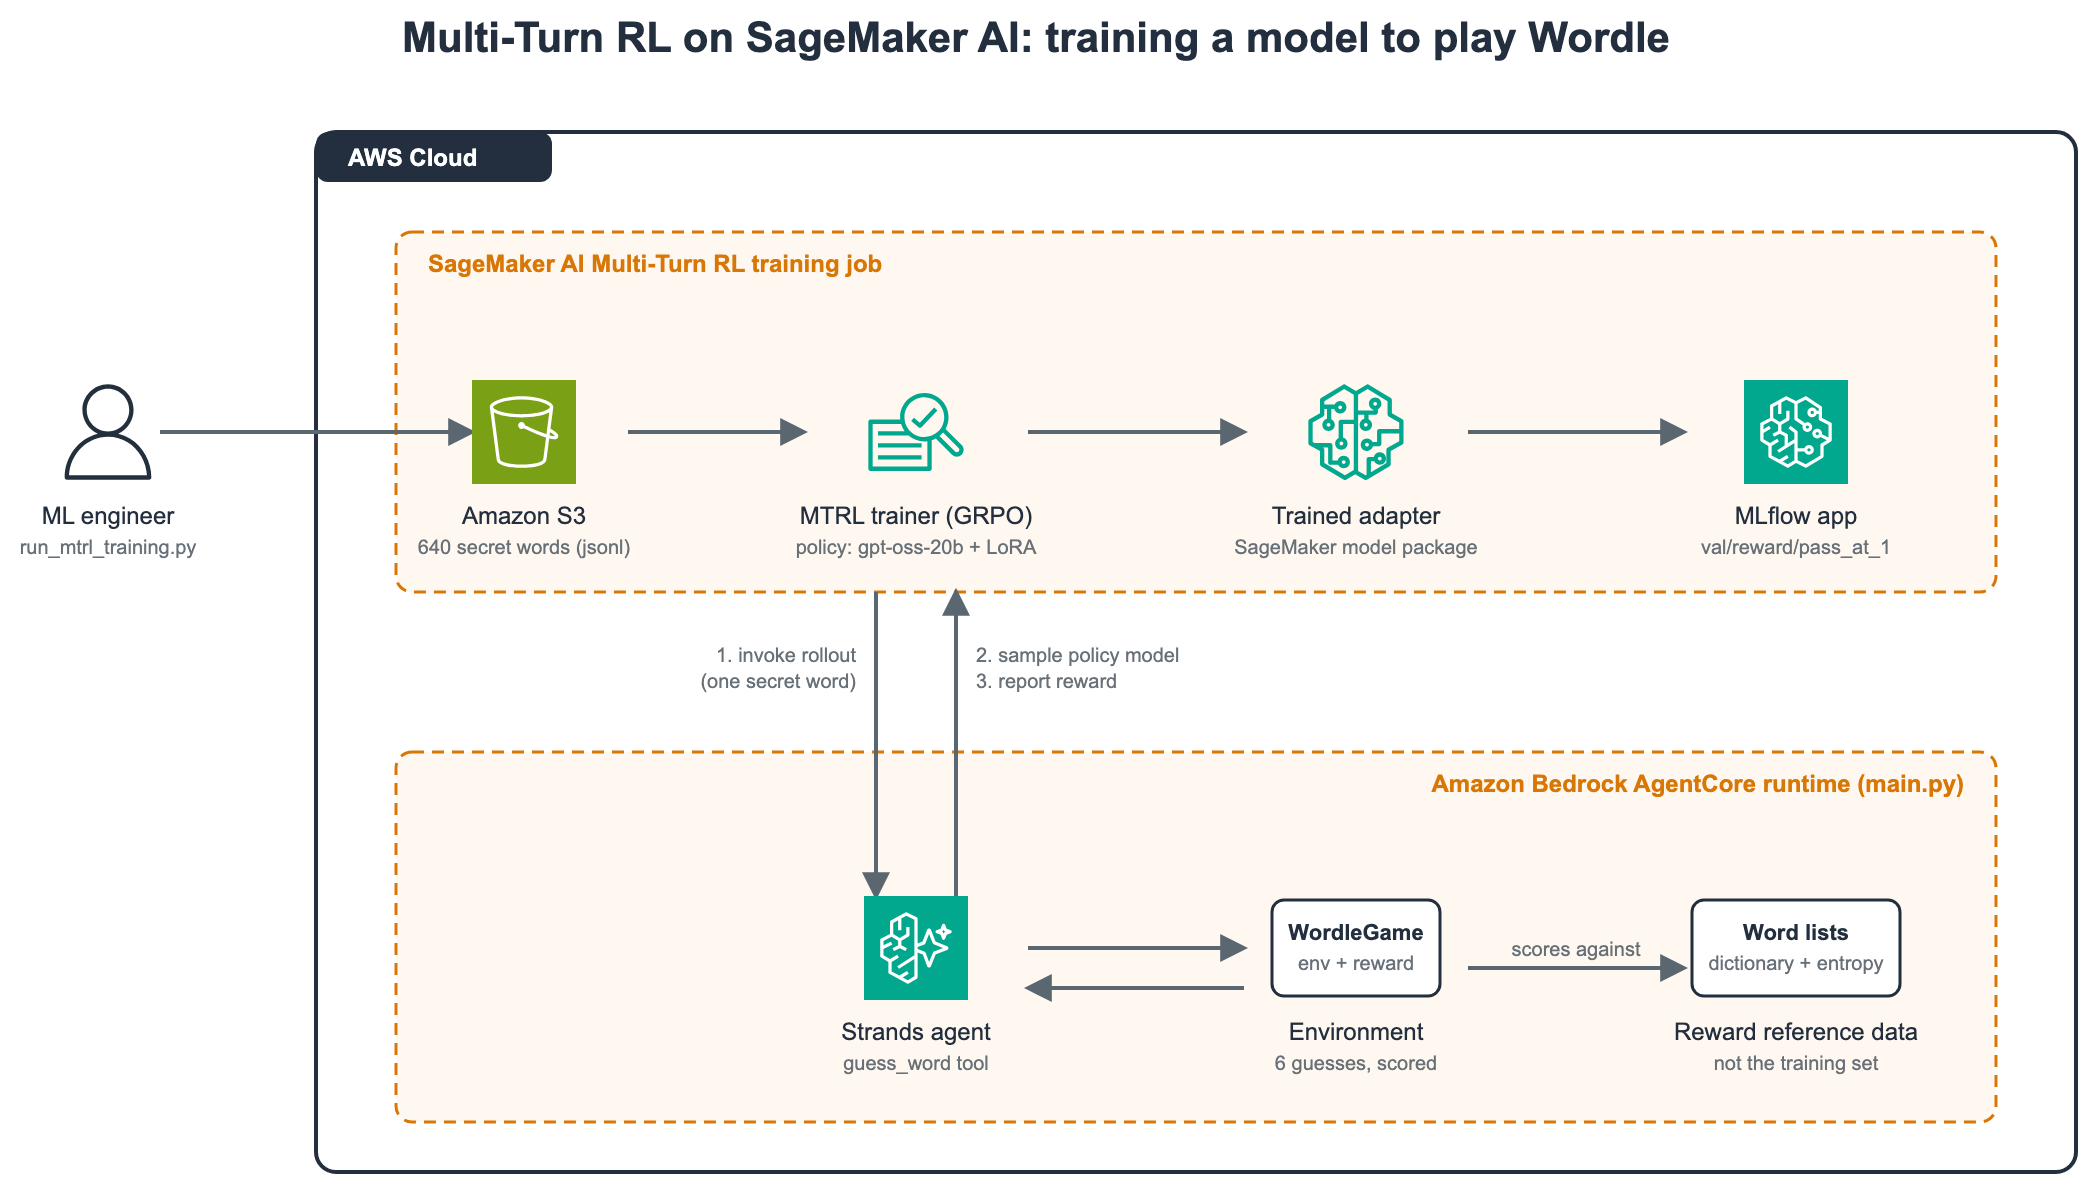
图 1:SageMaker AI 上的 MTRL,训练作业每次 rollout 调用一次 AgentCore 托管的智能体,以采样策略模型、进行游戏并报告奖励
对于每次 rollout,MTRL 服务都会调用 AgentCore 运行时(Amazon Bedrock AgentCore 的一项能力),并传入一行训练数据,其中包含一个秘密单词。运行时中的 Strands 智能体通过 SageMaker Job Runtime 的 OpenAI 兼容端点调用策略模型。模型通过一个工具 guess_word 最多进行六次猜测,每次猜测后环境都会返回逐字母反馈以及已知信息的摘要。游戏结束时,智能体返回一个奖励。Group Relative Policy Optimization (GRPO) 利用同一单词多次 rollout 之间奖励的分布差异,来更新策略模型上的低秩适配(LoRA)适配器。
以下内容有三点设计要点值得关注:
- 智能体与奖励位于同一处。部署到 AgentCore 的单个 Python 文件同时包含环境、工具和评分函数。
- 数据集只携带秘密单词。智能体附带的词表由开源 SCOWL 词表构建,仅用于评分。
- 奖励以结果为主导。解出谜题根据速度支付 1.05–1.55,失败支付 -0.5,从未做出有效猜测支付 -1.5。一个小的塑形项在每个层级内奖励良好的策略。
支持的模型与 AWS 区域
MTRL 是无服务器的:你选择一个基础模型,服务会配置训练和采样基础设施。在撰写本文时,它支持以下基础模型,每个模型都使用 LoRA 适配器进行训练:
| 基础模型 | AWS 区域 |
| Amazon Nova 2 Lite | 美国东部(弗吉尼亚北部)(us-east-1)、美国西部(俄勒冈)(us-west-2) |
GPT-OSS-20B |
美国东部(弗吉尼亚北部)(us-east-1)、美国西部(俄勒冈)(us-west-2) |
| Gemma 4 31B(指令微调) | 美国西部(俄勒冈)(us-west-2) |
| Qwen 3.6 27B | 美国西部(俄勒冈)(us-west-2) |
我们选择 GPT-OSS-20B,因为它在四者中每 token 价格最低,并且其推理强度可按请求控制。当前列表请参阅 MTRL 文档。
定价
你无需选择实例或配置集群规模。你按三个维度以每百万 token 付费,价格因基础模型而异:
- 预填充:策略模型处理的输入 token。这些在多轮任务中会累积,因为每一轮都会重新读取历史记录。
- 采样:策略模型生成的 token,包括推理 token。
- 训练:在更新 LoRA 适配器的反向传播中处理的 token。
这次 100 步的运行在 12 小时 40 分钟内、跨 105,486 次 rollout 消耗了 4.916 亿预填充 token、1.597 亿采样 token 和 6.433 亿训练 token。按撰写本文时美国东部(弗吉尼亚北部)区域(us-east-1)的 GPT-OSS-20B 目录价计算,约为 339 美元:
| 维度 | Token 数 | 每 1M 价格 | 成本 |
| 预填充 | 491,616,806 | $0.12 | $58.99 |
| 采样 | 159,737,098 | $0.30 | $47.92 |
| 训练 | 643,308,554 | $0.36 | $231.59 |
| 总计 | 1,294,662,458 | $338.50 |
训练维度占主导,并随轨迹长度扩展,因此更短的游戏和更简洁的推理可以降低账单。AgentCore 运行时按智能体使用的 vCPU 和内存单独计费。对于本次运行,根据运行时在 us-east-1 目录价下的 Amazon CloudWatch 使用指标,这部分约为 79 美元。DescribeJob 在 BillableTokenUsage 下报告 token 计数。当前费率请参阅 Amazon SageMaker AI 定价。
先决条件
要跟随本演练,你需要以下内容。另请参阅 MTRL 先决条件。
- 需要 Python 3.10 或更高版本、uv、Node 20 或更高版本,以及 AgentCore CLI(
npm install -g @aws/agentcore)。安装方法及 CLI 所需的 IAM 权限请参阅 Get started with Amazon Bedrock AgentCore。 - 在启动任务的机器上需要 botocore 1.43.37 或更高版本。这是首个包含
AgentRFTCreateJob操作的版本。 - 两个 AWS Identity and Access Management (IAM) 角色,详见步骤 1。
- 一个与 agent 位于同一区域的 Amazon Simple Storage Service (Amazon S3) 存储桶。训练任务也必须在同一区域运行,因为
CreateJob会拒绝跨区域的运行时 ARN。
步骤 1:创建 IAM 角色
MTRL 使用两个角色,其中一个角色的信任策略在通用 SageMaker AI 文档中并未提及。
Agent 运行时角色。该角色由 agentcore deploy 为你创建。它信任 bedrock-agentcore.amazonaws.com,并需要 AmazonSageMakerJobRuntimeAccess 托管策略,该策略允许 agent 调用策略模型并上报奖励。示例仓库中的 CDK 堆栈会自动附加此策略。
训练任务角色。该角色由你创建。它必须同时以 sts:AssumeRole 和 sts:TagSession 信任 job.sagemaker.amazonaws.com,并且需要 AmazonSageMakerJobFullAccess 托管策略。
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {"Service": "job.sagemaker.amazonaws.com"},
        "Action": ["sts:AssumeRole", "sts:TagSession"]
    }]
}注意:信任主体是 job.sagemaker.amazonaws.com,而不是 sagemaker.amazonaws.com。若使用通用主体,CreateJob 会失败并报“Could not assume role”,且只有在重试之后错误信息才会指出正确的主体。
步骤 2:将 agent 部署到 Amazon Bedrock AgentCore
克隆 示例仓库,在 Wordle/agentcore/aws-targets.json 中设置你的账户和区域,然后部署:
git clone https://github.com/aws-samples/sample-multi-turn-rl-wordle
cd sample-multi-turn-rl-wordle/Wordle
agentcore validate
agentcore deploy
CLI 会为运行时的 Linux ARM64 平台构建 agent 的依赖,创建附加了 AmazonSageMakerJobRuntimeAccess 的执行角色,并通过 AWS CloudFormation 进行部署。我们推荐这种方式,而不是在控制台上传代码包——在控制台上很容易把约 700 MB 的已编译依赖或策略附加弄错。请记下输出中的运行时 ARN,供训练任务使用。
图 2:Amazon Bedrock AgentCore 控制台中的 Wordle agent 运行时,状态为 Ready
运行时从 agentcore.json 读取两个环境变量。REASONING_EFFORT=low 会在每次向策略模型发起请求时设置 reasoning_effort。在我们的评估任务中,low effort 每局使用的样本 token 数比 medium 少 63% 到 83%。REASONING_PROMPT_HINT=true 还会在系统提示中加入“Reasoning: low”,这是 gpt-oss 在其 Harmony 聊天格式中读取该设置的方式。这两个变量都不会向模型透露任何关于秘密单词的提示。
图 3:运行时环境变量,显示 REASONING_EFFORT 设置为 low
该 agent 只有一个文件,即 main.py。简化后的入口点如下所示。对于你自己的任务,你需要修改任务解析、工具和奖励部分:
app = BedrockAgentCoreApp()

@app.entrypoint  # outermost: starts the HTTP server AgentCore invokes
@sagemaker_rft_handler  # reports the returned reward to SageMaker AI
def handle_rollout(payload):
    prompt, answer = parse_task(payload["prompt"])
    game = WordleGame(answer)

    @tool
    def guess_word(guess: str) -> str:
        """Submit a 5-letter Wordle guess and get feedback."""
        return game.guess(guess)

    agent = Agent(model=build_model(), system_prompt=SYSTEM_PROMPT, tools=[guess_word])
    agent(prompt)
return {"reward": game.final_reward()}重要:sagemaker_rft_handler 装饰器本身不会启动 HTTP 服务器。请用 BedrockAgentCoreApp 和 @app.entrypoint 将其包裹,并让入口点装饰器位于最外层。否则,每次调用都会在 30 秒后超时。
步骤 3:验证运行时
在消耗 GPU 时间之前,先用一个与训练服务所发送格式相同的负载确认整条链路可以正常工作。仓库中提供了一个示例,位于 Wordle/payload.json:
{
  "prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"beach\", \"id\": \"smoke-test\"}",
  "metadata": {
    "jobArn": "arn:aws:sagemaker:us-east-1:111122223333:job/AgentRFT/smoke-test",
    "rolloutId": "r1"
  }
}
这个伪造的任务 ARN 预期会失败,而它失败的方式正是证明。请先填入你自己的账户 ID:对于其他账户中的任务 ARN,服务会在检查任务是否存在之前就返回 403,这看起来像是 IAM 配置有问题。在 Wordle 目录下运行:
ACCOUNT=$(aws sts get-caller-identity --query Account --output text)
sed "s/111122223333/$ACCOUNT/" payload.json > /tmp/payload.json

aws bedrock-agentcore invoke-agent-runtime \
  --agent-runtime-arn <RUNTIME_ARN> \
  --runtime-session-id smoke-test-$(date +%s)000000000000000 \
  --payload fileb:///tmp/payload.json /dev/stdout
在运行时的 Amazon CloudWatch 日志中,你会看到智能体解析提示词、向 Job Runtime 端点进行身份验证,并收到一个 400 错误,内容为“Could not find job.”。该失败证实了解析、身份验证和错误报告均正常工作。命令本身会打印 {"reward": -1.5},因为智能体从未到达策略模型。403 错误“not authorized to access this resource”意味着作业 ARN 仍指向另一个账户。而 30 秒超时则意味着 HTTP 服务器没有启动(参见第 2 步中的重要说明)。
第 4 步:准备数据集
MTRL 数据集没有目标响应、对话记录或标签。每一行都是智能体要尝试的一项任务。以下是训练文件的前三行:
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"riser\", \"id\": \"wordle_train_0000\"}"}
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"swoon\", \"id\": \"wordle_train_0001\"}"}
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"dirty\", \"id\": \"wordle_train_0002\"}"}
服务读取 prompt 列(或第一列),并将该字符串原样传递给智能体,不进行解析。我们将该字符串设为包含三个字段的小型 JSON 对象:
- prompt:智能体展示给策略模型的指令,每一行都相同。
- answer:秘密单词。只有环境和奖励函数使用它。策略模型永远不会看到它。
- id:行 ID,用于在日志中将一次 rollout 追溯到其来源行。
示例仓库的 make_dataset.py 从答案列表中抽取 640 个训练单词(五个完整的 128 批次)和 128 个验证单词,二者无重叠,因此验证解决率衡量的是泛化能力。该服务还接受 Apache Parquet、JSON 数组和 CSV。将两个文件上传到 Amazon S3:
uv run python make_dataset.py
aws s3 cp training-data.jsonl s3://<YOUR_BUCKET>/wordle-mtrl/train/
aws s3 cp validation-data.jsonl s3://<YOUR_BUCKET>/wordle-mtrl/validation/
由于服务从不检查 prompt 字符串,生产任务可以将完整的消息列表、工具配置或奖励规范打包进去。有关示例,包括如何保护字符串中的敏感内容,请参阅 MTRL 文档。
第 5 步:启动训练作业
启动器使用 sagemaker-train SDK 中的 MultiTurnRLTrainer 类。将其指向第 2 步的运行时 ARN、第 1 步的角色、第 4 步的数据集,以及用于指标的 MLflow 应用。MLflow 应用是必需的,因此如果你没有,请先用 aws sagemaker create-mlflow-app 创建一个:
uv run python run_mtrl_training.py \
  --model openai-reasoning-gpt-oss-20b \
  --agent-runtime-arn <RUNTIME_ARN> \
  --role-arn arn:aws:iam::<ACCOUNT>:role/<JOB_ROLE> \
  --train-dataset s3://<YOUR_BUCKET>/wordle-mtrl/train/training-data.jsonl \
  --val-dataset s3://<YOUR_BUCKET>/wordle-mtrl/validation/validation-data.jsonl \
  --s3-output-path s3://<YOUR_BUCKET>/wordle-mtrl/output/ \
  --mlflow-app-arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>
启动器覆盖三个超参数,其余所有超参数保持 gpt-oss-20b 的默认值。它将 sampling_max_tokens 设为 8192,即服务最大值,因为在默认值 4096 下,gpt-oss 在推理时经常在第一次工具调用之前就耗尽 token。它将 max_epochs 设为 20,max_steps 设为 100:640 行在默认 global_batch_size 为 128 的情况下,每个 epoch 为 5 步,而在默认 group_size 为 8 的情况下,每一步进行 1,024 局游戏。作业会依次经过 Starting、Downloading 和 Pending,然后进入 Training。进入训练后,你的 AgentCore 运行时开始接收 rollout 调用。
重要:作业运行期间不要重新部署智能体。重新部署会重启运行时,进行中的 rollout 看不到采样请求,服务会使整个作业失败。
第 6 步:在 MLflow 中监控训练
服务在每一步记录奖励、token 和轮次统计信息,并每 val_every 步运行一次验证。需要关注的指标是 val/reward/pass_at_1,即解决的留出单词比例。每次解决得分至少为 1.01,因此超过服务的 success_threshold 阈值 1.0,pass@1 会计入。下图基于本次运行的 MLflow 历史记录构建:
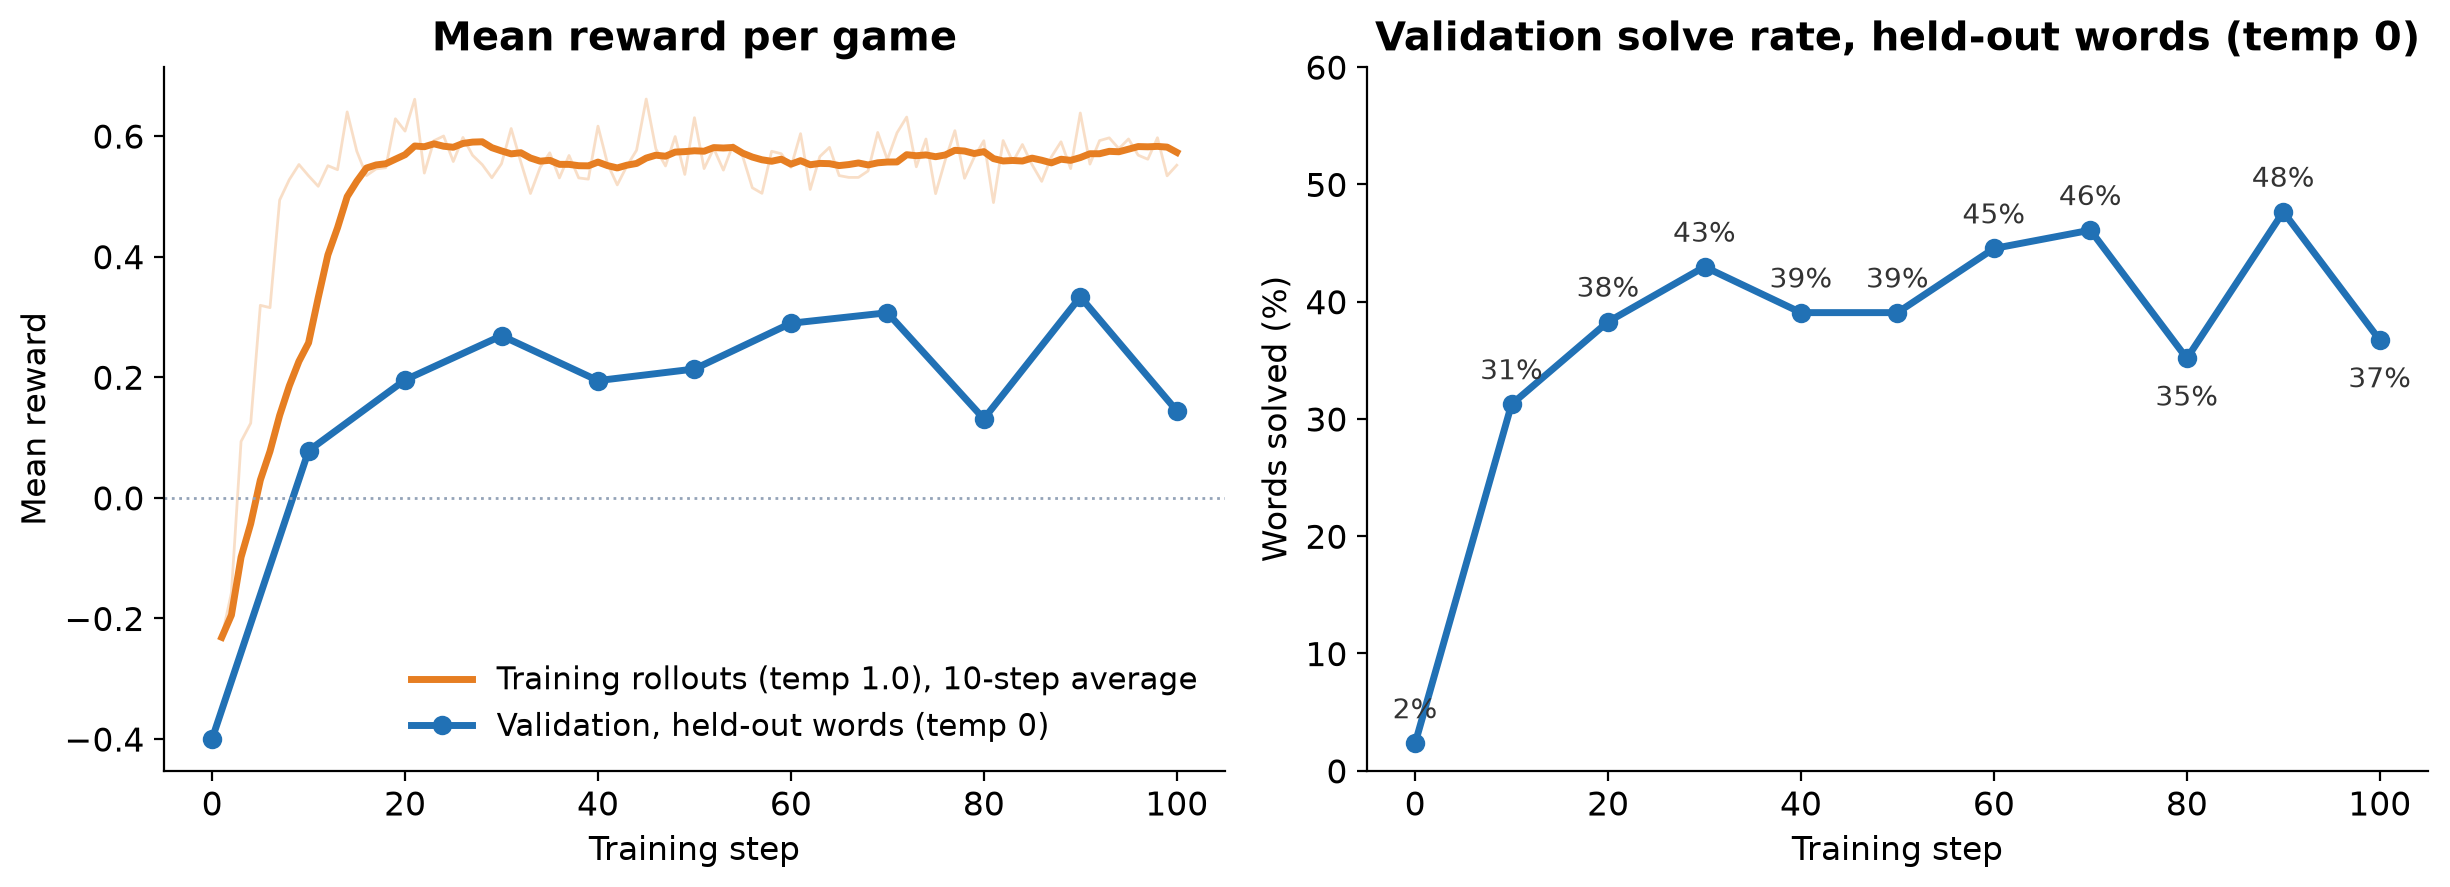
图 4:100 步运行的训练曲线,左侧为每局平均奖励,右侧为验证解决率
训练奖励在 15 步内攀升至约 +0.57 并保持在该水平。验证奖励较低,主要原因是温度 1.0 与 0 的差异,而非过拟合(见第 7 步)。验证求解率在前 10 步从 2% 跃升至 31%,随后在 35% 到 48% 之间波动。在 128 个词的情况下,这些波动主要是噪声。我们未测试在服务设置下增加步数是否有帮助。
运行时在 CloudWatch 中的 OpenTelemetry 追踪记录了每一次模型回合和工具调用。以下是训练后的模型在一次评估任务中玩的一局游戏(中等努力,温度 1.0),推理过程已精简。秘密词是 PASTE:
[model] Reasoning: [...] "CRANE" has 5 distinct letters: C,R,A,N,E. [...]
We'll guess "CRANE".
Tool call: guess_word(guess="CRANE")
[tool] Guess 1/6: CRANE -> C=gray, R=gray, A=yellow, N=gray, E=green
Current Knowledge:
- Correct Position (Green): _ _ _ _ E
- In Word, Wrong Position (Yellow): 'A' (at least 1)
- Not in Word (Gray): C, N, R
- Guesses Remaining: 5
[model] Reasoning: [...] "ALIVE": ends with E, includes A. Letters not C,N,R.
Tool call: guess_word(guess="ALIVE")
[tool] Guess 2/6: ALIVE -> A=yellow, L=gray, I=gray, V=gray, E=green
[model] Reasoning: [...] So positions not 1 or 3 for A. Positions left: 2,4
for A. [...] We might guess "HASTE"? [...]
Tool call: guess_word(guess="HASTE")
[tool] Guess 3/6: HASTE -> H=gray, A=green, S=green, T=green, E=green
[model] Reasoning: We have the word: _ASTE. [...] "PASTE" is a word. PASTE
fits. Also "WASTE" also fits [...] Choose "PASTE" maybe.
Tool call: guess_word(guess="PASTE")
[tool] Guess 4/6: PASTE --- all green. Correct, you solved it!
来自 AgentCore 运行时追踪的训练模型 rollout。模型将绿色字母保留在原位,从不重复使用灰色字母,并利用每个黄色字母排除位置,尽管训练数据中没有任何内容教它这样做。
第 7 步:在服务设置下评估训练后的模型
任务完成后,其在 SageMaker AI Studio 中的页面会显示状态以及保存训练后模型的模型包组。DescribeJob,将 JobCategory 设为 AgentRFT,返回输出模型包 ARN 和计费 token 数。
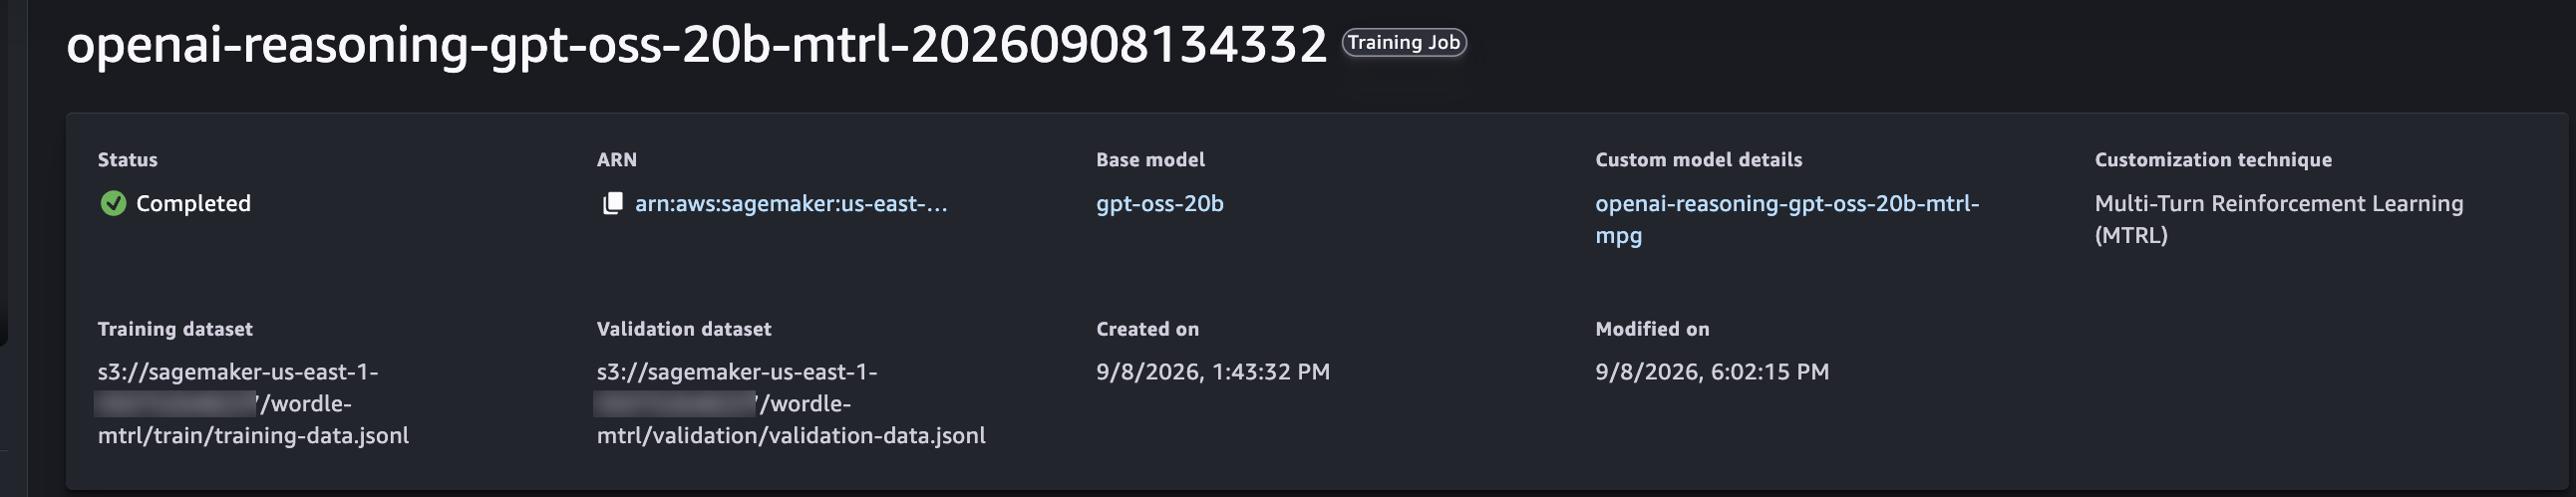
图 5:SageMaker AI Studio 中 Jobs、Training、Multi-turn RL 选项卡上已完成的训练任务
一个评估任务(JobCategory 设为 AgentRFTEvaluation)通过相同的 AgentCore 运行时和奖励,在基础模型或训练后的包上运行你的评估提示,并将 eval/reward/pass_at_1 记录到 MLflow。与训练验证不同,你可以设置温度。仓库的启动器会连续运行评估,因为默认配额一次只允许一个评估任务(你可以申请提高配额):
uv run python run_mtrl_eval.py --runs base:1.0 trained:1.0 \
  --model-package-arn <OUTPUT_MODEL_PACKAGE_ARN> \
  --agent-runtime-arn <RUNTIME_ARN> \
  --role-arn arn:aws:iam::<ACCOUNT>:role/<JOB_ROLE> \
  --dataset s3://<YOUR_BUCKET>/wordle-mtrl/validation/validation-data.jsonl \
  --s3-output-path s3://<YOUR_BUCKET>/wordle-mtrl/eval/ \
  --mlflow-app-arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>
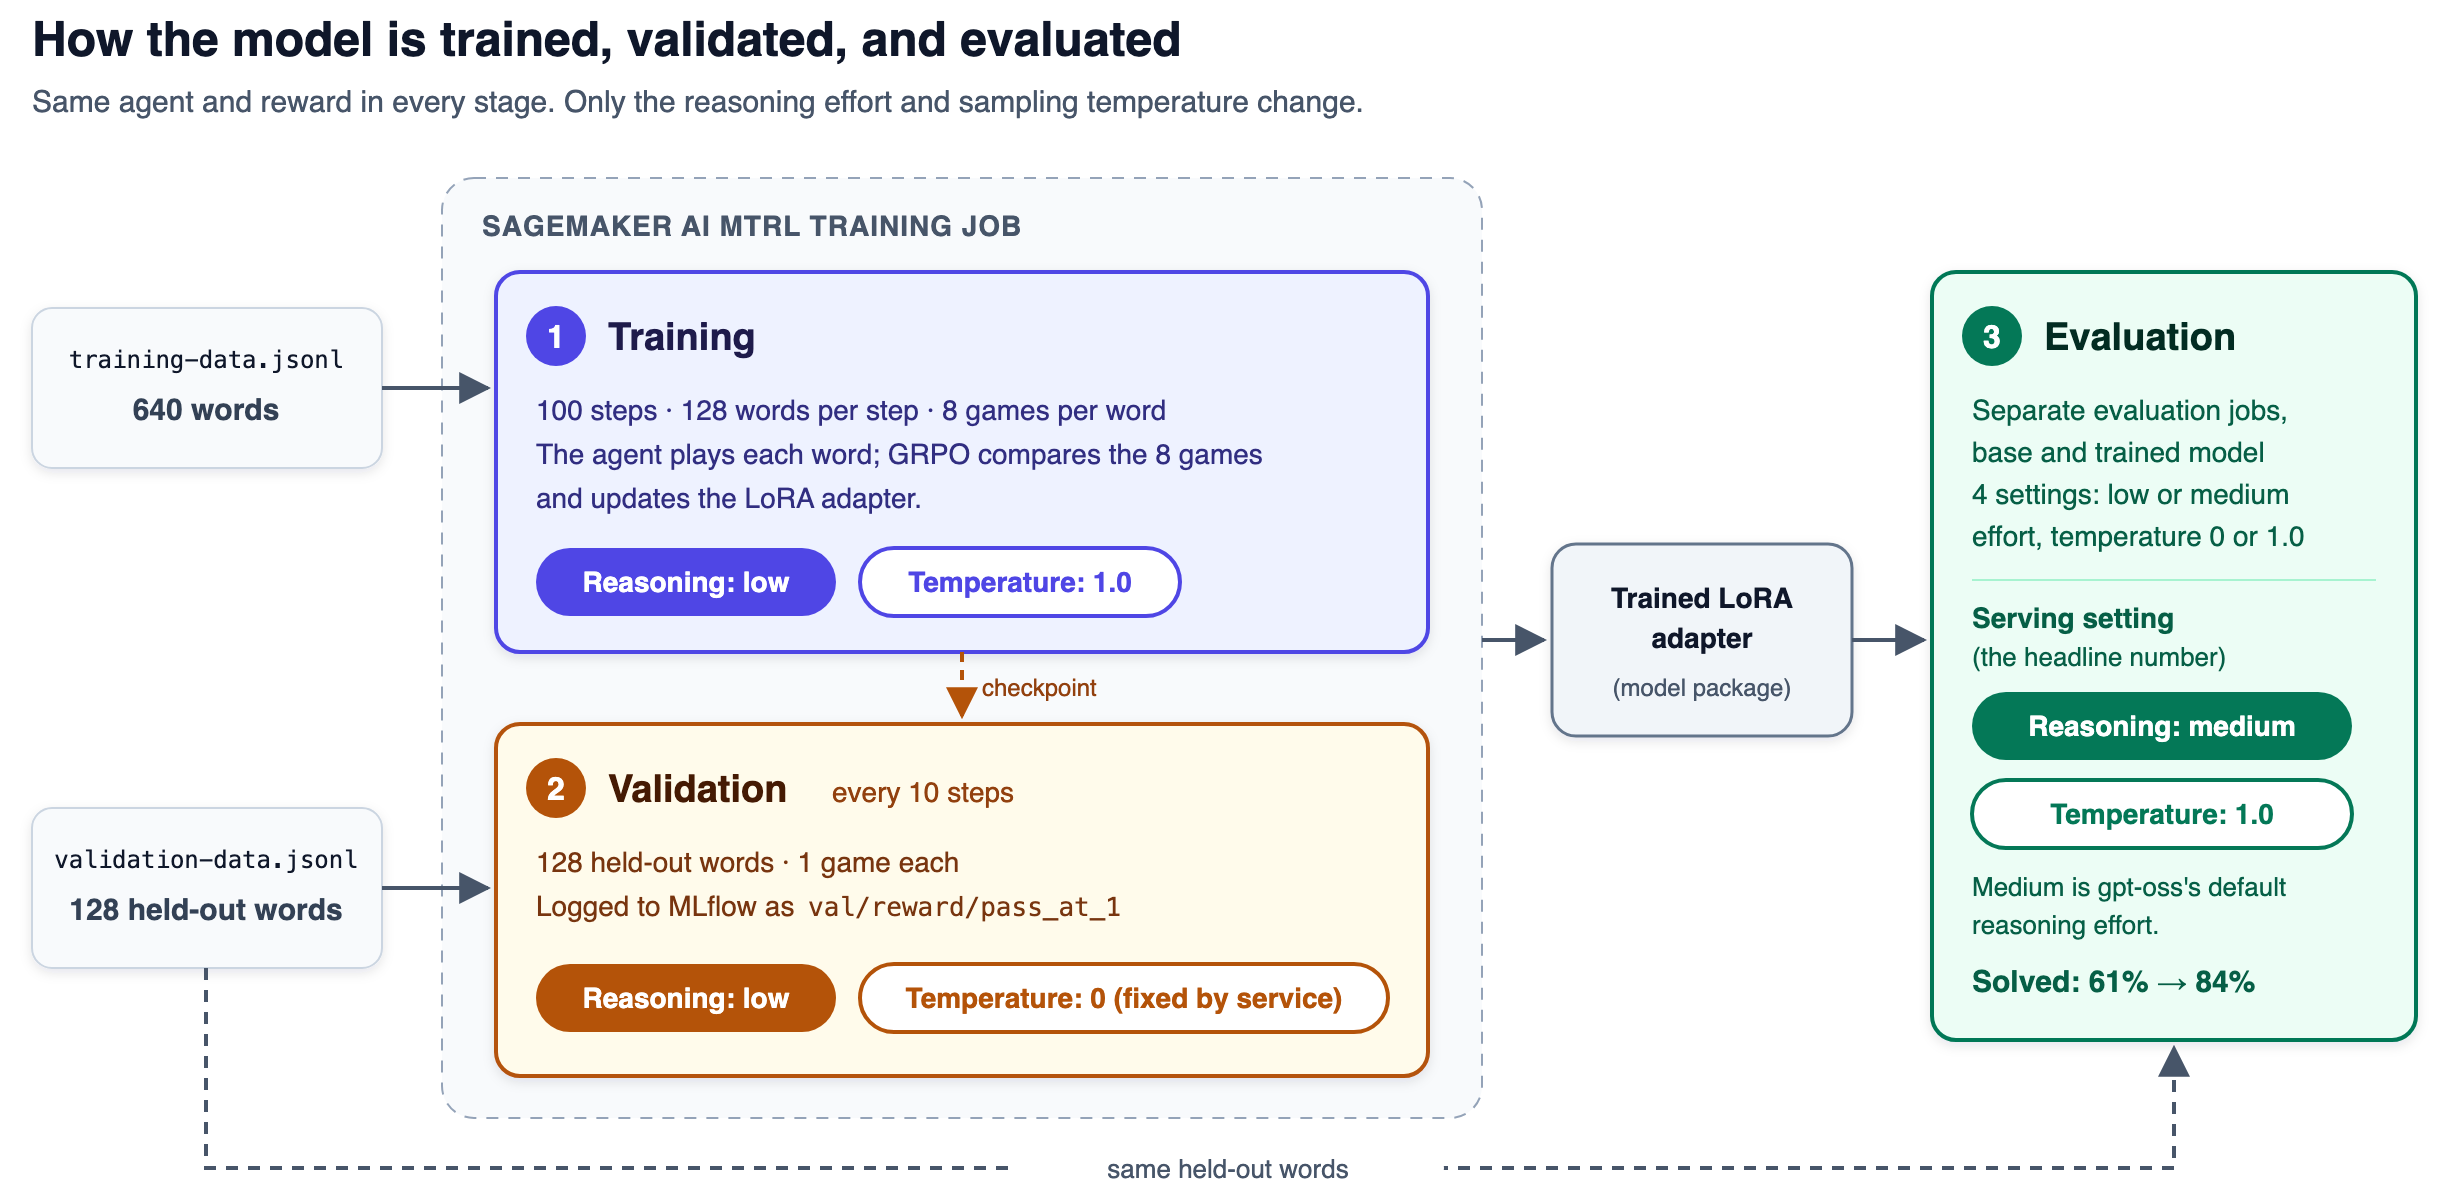
图 6:各阶段的推理努力和采样温度,其中训练任务将验证固定为温度 0 和部署时的努力程度,而评估任务允许你选择
每次 128 词的评估耗时四到七分钟。推理努力来自智能体的环境变量,因此要更改它,需编辑 REASONING_EFFORT、重新部署并评估。我们在低和中等努力以及温度 0 和 1.0 下评估了两个模型:
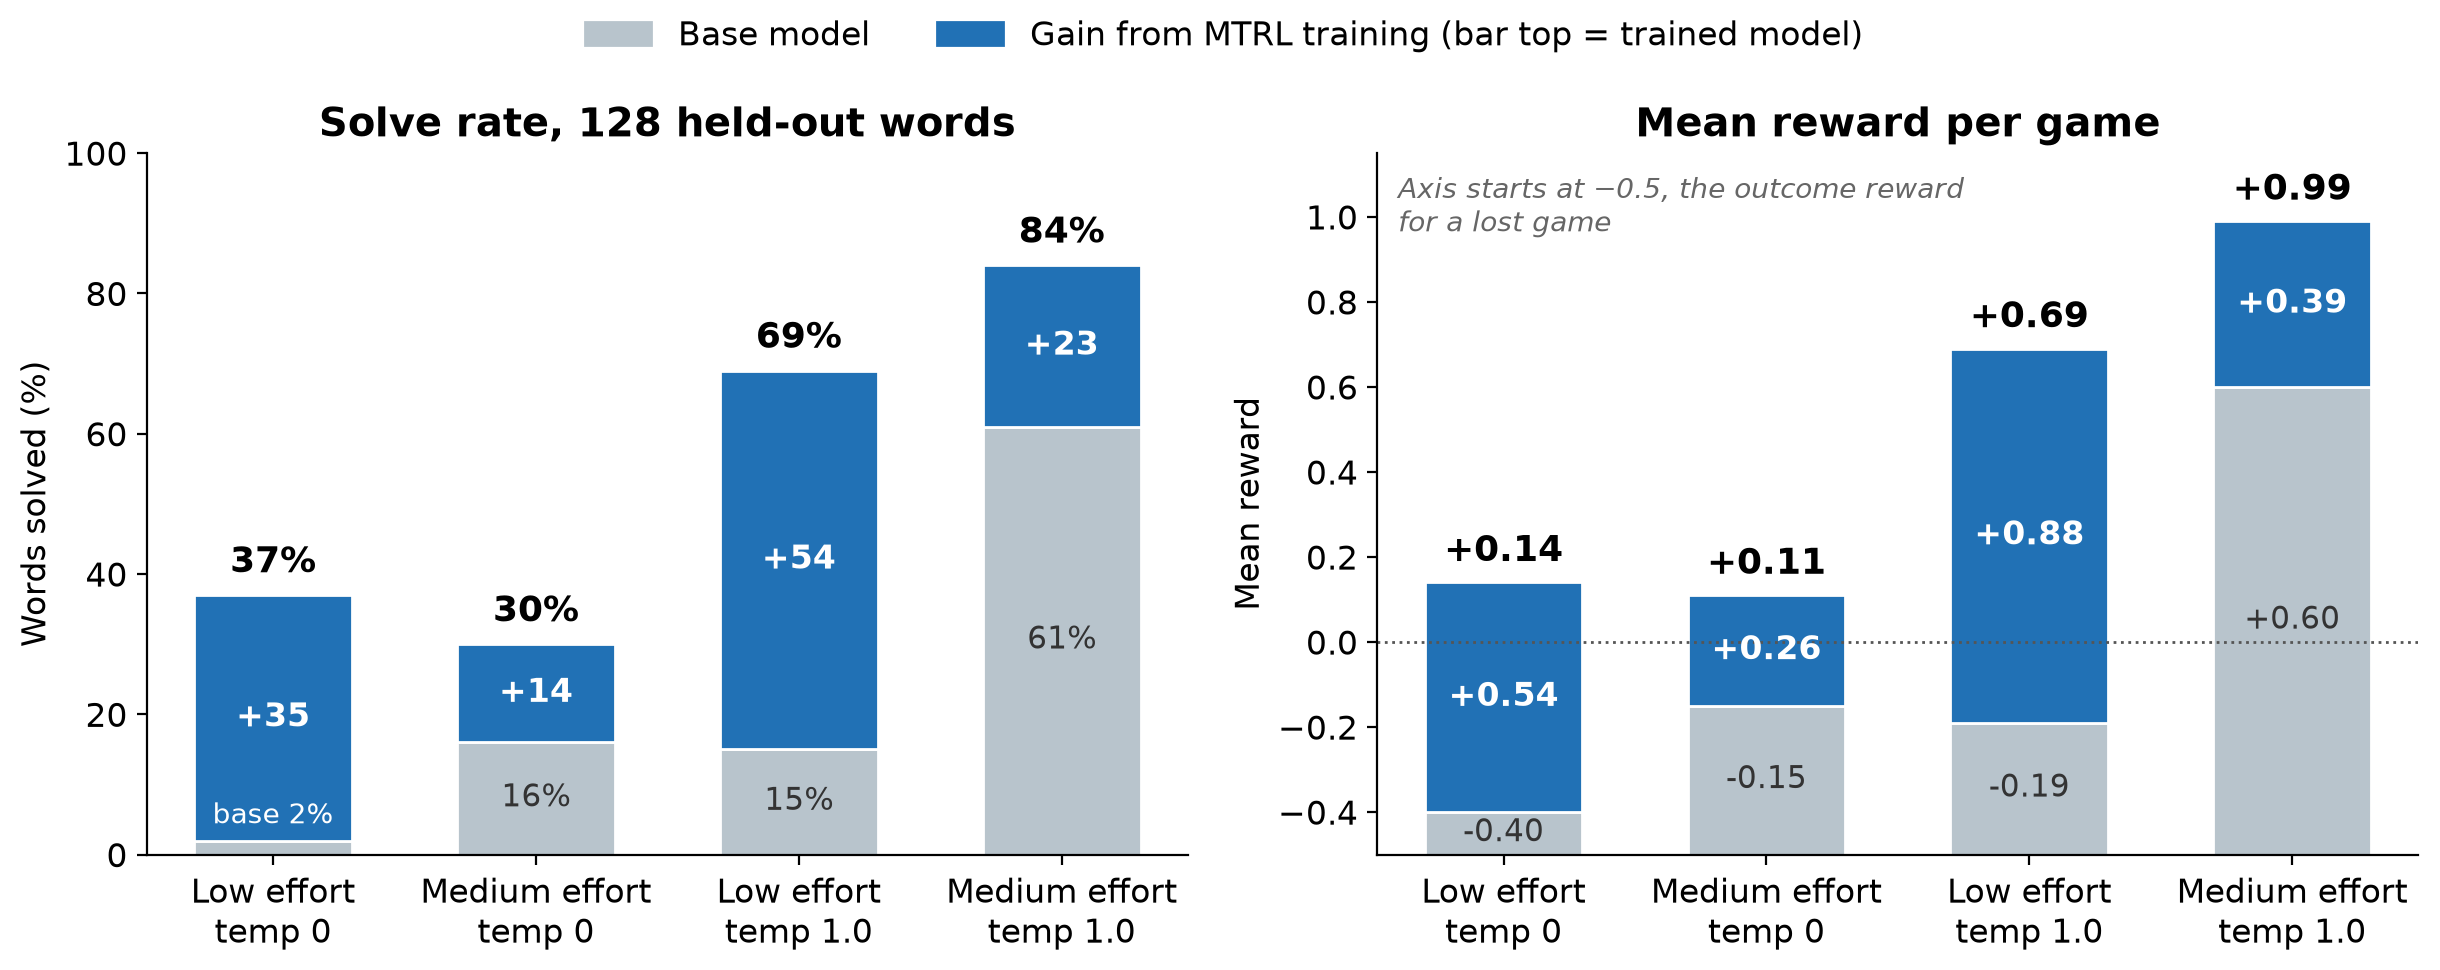
图 7:四种解码设置下基础模型与训练后模型的对比,左侧为求解率,右侧为每局平均奖励
每个条形图的灰色部分为基础模型,蓝色部分为训练带来的增益。低努力、温度 0 的那一对是训练任务在第 0 步和第 100 步的验证结果。中等努力、温度 1.0 的训练后结果是两次运行的平均值(80% 和 88%)。
在温度 0 下,无论努力程度如何,两个模型都经常在未求解的情况下结束游戏。开启采样后,中等努力为训练后模型增加 15 个百分点,为基础模型增加 46 个百分点。适配器在每种设置下都增加 14–54 个百分点,因此训练所学到的内容可以跨设置迁移。
训练任务自身在 MLflow 中的验证曲线则讲述了不同的故事:它在第 90 步达到 48% 的峰值,最终为 37%,评分温度为 0。超参数参考建议评估时使用温度 0,因为贪婪解码使曲线具有确定性且可在不同运行间比较。我们报告温度 1.0 的结果,因为这是我们服务模型的方式。在中等努力和温度 1.0 下,训练后模型解决了 84% 的留出词,高于基础模型的 61%。
提示:请在你将要提供服务的设置下进行评估。训练曲线显示该适配器最终达到 37%。在服务设置下,它能解决 84%。展示这一点的评估任务花费约 $1.20 的 token,耗时约一小时。
第 8 步:清理
训练和评估任务完成后即停止计费,但 AgentCore 运行时、其 IAM 角色、MLflow 应用和 S3 对象会保留。在项目目录下执行:
# 1. Agent runtime and its execution role. remove all resets the project config;
# the next deploy sees the empty state and tears down the deployed resources.
cd sample-multi-turn-rl-wordle/Wordle
agentcore remove all
agentcore deploy

# 2. MLflow app
aws sagemaker delete-mlflow-app --arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>

# 3. Datasets, job output, and evaluation output
aws s3 rm s3://<YOUR_BUCKET>/wordle-mtrl/ --recursive
由于 agentcore remove all 会重写 agentcore/ 下的文件,如果你之后想重新部署,请运行 git checkout -- agentcore/。删除 AgentCore-Wordle-default CloudFormation 堆栈会移除相同的资源,但不会动这些文件。训练任务角色和模型包不计费。
深入探讨:设计奖励
我们的奖励需要一次修订,而这个错误很常见。
最初的设计把 wordle-lora-rl 项目中每次猜测的评分在整个游戏上求和。那种评分在那里有效,是因为每次猜测都是独立的训练样本。求和为每局一个奖励后,它产生了两个倒挂,我们只有通过阅读轨迹才发现:
- 输掉的游戏得到正奖励。六轮的奖励加起来约为 +0.49。
- 第 1 轮就解出得分低于第 3 轮解出。第一次猜测就解出得 +0.99,第三次猜测解出得 +1.61,因为额外的轮次收集了更多奖励。
修复方案将主导的结果项与一个小的、有界的塑形项分开:
reward = outcome + w * clip(shaping, -1, 1), w = 0.04 if solved, else 0.15结果项完全由游戏如何结束决定:
| 结果 | 值 |
| 第 n 次猜测解出 | 1.05 + 0.5 * (6 – n) / 5,因此第 1 次猜测为 1.55,降至第 6 次猜测的 1.05 |
| 用完全部六次猜测,未解出 | -0.5 |
| 从未做出有效猜测 | -1.5 |
塑形项就是每次猜测的评分,在整个游戏上求和:
- 对与已知绿色、黄色或灰色字母矛盾、重复猜测以及词典外单词的惩罚。
- 对强开局词的熵奖励。
- 对尝试新字母和缩小剩余可能性集合的奖励。
总和被裁剪到 [-1, 1],并在解出时缩放 0.04、失败时缩放 0.15,因此它能区分结果相同的游戏,但绝不会把游戏移入另一个层级。在典型塑形值下:
| 场景 | 奖励 |
| 第 1 次猜测解出 | +1.550 |
| 第 3 次猜测解出 | +1.375 |
| 第 6 次猜测解出 | +1.069 |
| 六次猜测后失败 | -0.427 |
| 从未做出有效猜测 | -1.500 |
更快的解出现在总是优于更慢的解出,每次解出都优于每次失败,而从不游玩是最差的结果。我们最初的修复使用单一权重 0.15,这使得第 3 次猜测解出且塑形满分(+1.45)的得分高于第 2 次猜测解出且塑形最低(+1.25)的得分。相邻猜测次数相差 0.1,因此更小的解出权重 0.04 消除了重叠,而最差的解出(+1.01)仍能越过 1.0 的成功阈值。塑形仍然重要,因为 GRPO 从组内的奖励方差中学习,所以两局在线索一致性上不同的失败游戏仍能教给模型一些东西。正如 SageMaker AI 文档所建议的,从基于结果的奖励开始,谨慎添加塑形,并在真实轨迹上检查奖励。
深入探讨:出了什么问题,按你将遇到的顺序
这些每一项都至少耗费了一次训练运行。
- 并发下的 Bearer 令牌。每次调用都用新的 botocore 会话铸造令牌,在 32 个并发 rollout 时耗尽了凭证提供方,而将令牌缓存一小时会随着凭证轮换返回 403 错误。修复方案是一个自刷新会话、一个短缓存,以及在 403 时重新签名。
- 从未到达策略模型的 rollout 会让整个任务失败。当一次 rollout 中的每次模型调用都认证失败时,服务会以“No sampling requests were received.”结束任务。返回错误状态同样会导致失败,因此务必始终返回奖励。模型被采样但从未做出有效猜测的游戏没有问题:它得 -1.5 分,在 100 步的运行中,约 105,000 次 rollout 里有 51 次属于这种情况。
- 工具调用漂移成纯文本。学习率过高时,模型把工具调用写成文本,每次 rollout 都得到相同的最低奖励,梯度随之消失。现在智能体会从原始文本中恢复猜测,并施加少量格式惩罚。
- 平台期。训练奖励在约第 15 步后停止上升,验证在约第 30 步后停止改善,不过在温度 0 下验证会低估模型(第 7 步)。我们接下来会尝试的是一种用先验猜测为游戏播种的课程安排,或者每个词使用比默认
group_size的 8 次更多的 rollout。
结论
在 SageMaker AI 上,MTRL 根据整个 episode 的结果来训练模型。这适合智能体任务——正确的轨迹未知,只有结果可以评分。我们使用了单一的 episode 级奖励。当中间步骤也可以评分时,MTRL 还通过 UpdateReward API 接受每轮一个奖励。在本文中,一个开放权重的 20B 模型在服务设置下达到了 84% 的解决率,高于此前的 61%,训练 token 成本约 339 美元,AgentCore 运行时使用成本约 79 美元。训练曲线报告的 37% 是训练任务对验证评分方式造成的假象,因此请在你实际服务的设置下进行评估。
同一套流程也适用于公开模型从未训练过的内部流程、工具和工作流。
要开始使用,请克隆示例仓库,按照前面的步骤操作,并在投入 GPU 时间之前运行第 3 步中的冒烟测试。有关底层 API,请参阅 SageMaker AI MTRL 文档。
关于作者

Daniel Quang
Daniel 是 AWS Frontier AI Startups 团队的解决方案架构师,帮助全球最大、最具战略意义的生成式 AI 初创公司在云上扩展其基础设施。他拥有加州大学欧文分校的计算机科学博士学位,研究方向为机器学习和生物信息学。

Hadrien Almela
Hadrien 是 AWS 初创团队的高级 Frontier AI 客户经理,帮助顶尖 AI 初创公司建立技术集成和全球市场推广(GTM)合作。他在初创企业领域拥有八年经验。

Vinay Bhat
Vinay 是 AWS Frontier AI 解决方案架构负责人,领导一支技术专家团队,帮助基础模型实验室和 AI 原生初创公司在 AWS 上构建、训练和扩展其模型与应用。他在 AWS、Google Cloud 和高增长初创公司拥有超过 20 年的技术团队建设经验。
来源:AWS Machine Learning Blog · aws.amazon.com