AI 智能体的土拨鼠之日:在 Amazon Bedrock 上使用 OpenAI 模型的提示词缓存模式
Groundhog Day for AI agents: Prompt caching patterns for using OpenAI models on Amazon Bedrock
AWS 高级解决方案架构师 Claudio Mazzoni 撰文介绍在 Amazon Bedrock 上调用 OpenAI 模型时,如何用提示词缓存避免智能体每轮重复读取全部上下文。
作者以 Amazon Bedrock 团队身份给出可复用的提示词缓存代码模式,读者可据此降低智能体多轮调用的输入成本。
每次你启动 agent,它在执行操作前都必须重新读取自己的完整历史。下面介绍如何让它记住,而不必反复喂给它相同的上下文。
在电影《土拨鼠之日》中,比尔·默里饰演的角色每天都会重新经历同一个 2 月 2 日。他在同一家旅店、同一个小镇醒来,收音机里放着同一首歌,日复一日——一些影迷估算这样的循环持续了 34 年。
他前一天取得的任何成果都不会延续,除非他从头再重新完成一遍。AI agent 也生活在某种《土拨鼠之日》里。agent 每走一步(调用工具、读取结果、决定下一步做什么),都必须把到目前为止的完整历史发送给模型以保持连续性:工具定义、指令、此前每一次工具调用以及每一个结果。模型只根据你提供的输入预测下一个 token。它在请求之间没有内部记忆,因此必须把这一切重新读一遍。在一次编码会话进行到第 20 轮时,模型会重新读取第 1–19 轮,而你要为这些 token 一次又一次地付费。
提示缓存打破了这一循环。服务会存储你的输入提示(指令、工具和内容),并在下一次请求时复用它,价格仅为输入价格的一小部分。
在本文中,我将带你走过一个 agent 的一生,从它的第一轮,到它获得新工具并派生出助手。在此过程中,我会展示提示缓存如何降低成本,并让 agent 保持响应迅速且行为一致。
agent 向 LLM 发送什么
在讨论缓存之前,先看看一个典型 agent 首次调用大语言模型(LLM)时包含哪些内容会有所帮助:
- 工具列表 – agent 可调用的每个函数的定义。发布新版本时会变化。
- 指令 – 开发者提示:规则、角色设定、策略、示例。同样会随版本变化。
- 历史 – 本次会话到目前为止发生的一切:任务、模型的工具调用以及工具结果(每轮都会增长)。
- 新一轮 – 最新的工具结果或用户消息(每次可能不同)。
如果不设置缓存,agent 每一轮向模型发送的内容:
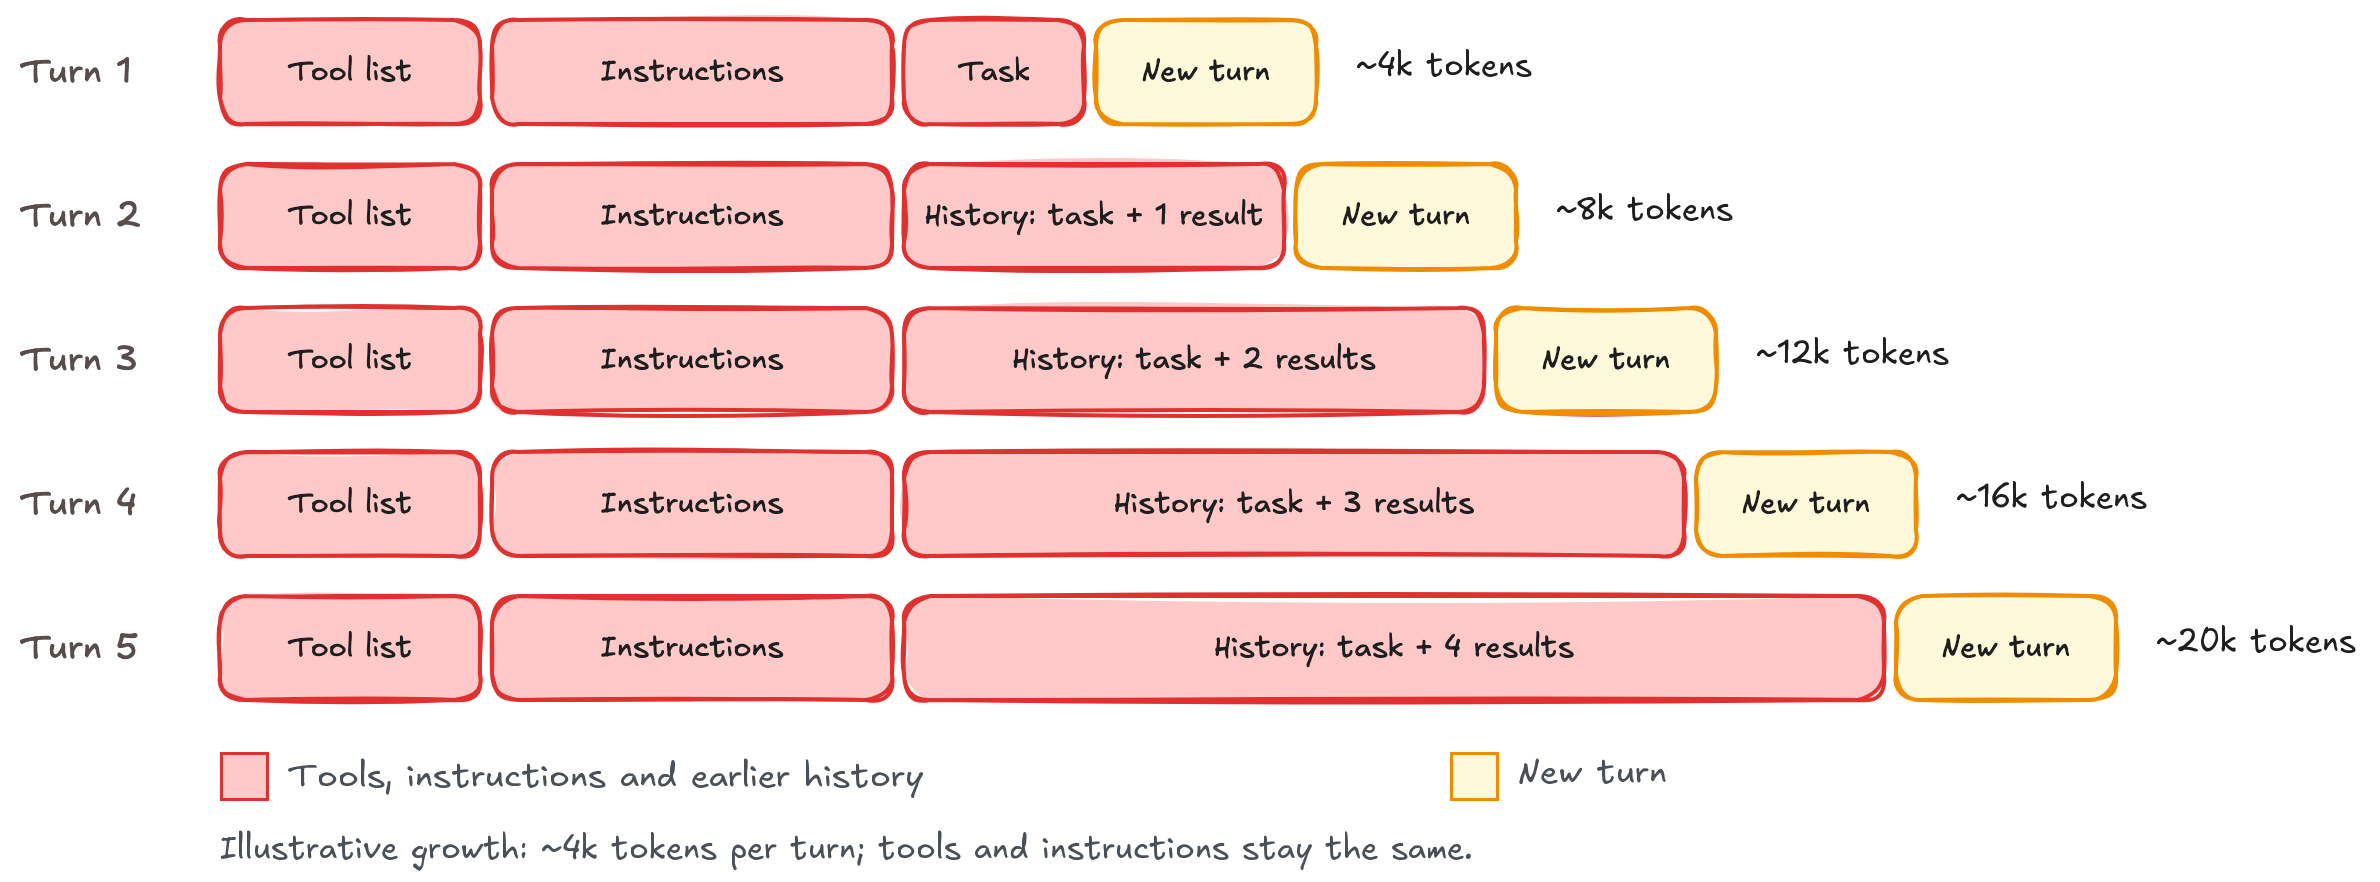
图 1:agent 每一轮向模型发送的内容
提示缓存的底层工作原理
当模型读取提示时,它首先执行一次称为预填充的写入。在预填充期间,它处理每个输入 token 并构建键值向量(也称为 key-value,或 KV),这些向量构成模型的工作状态。这发生在模型写出第一个 token 之前。
提示缓存会保存该状态,其中包含系统提示、工具、内容、历史等。当后续请求以相同的输入 token(即相同的文本)开头时,提示缓存服务会加载已保存的状态,而不是重新计算。然后它只处理下一次发送给模型的载荷中新增的部分。提示缓存可以是隐式的,由 Amazon Bedrock 选择可复用前缀的结束位置;也可以是显式的,由你的代码使用 prompt_cache_breakpoint 标记该端点。你可以同时使用这两种方式,我们也建议这样做。
第 1 轮与第 2 轮对比
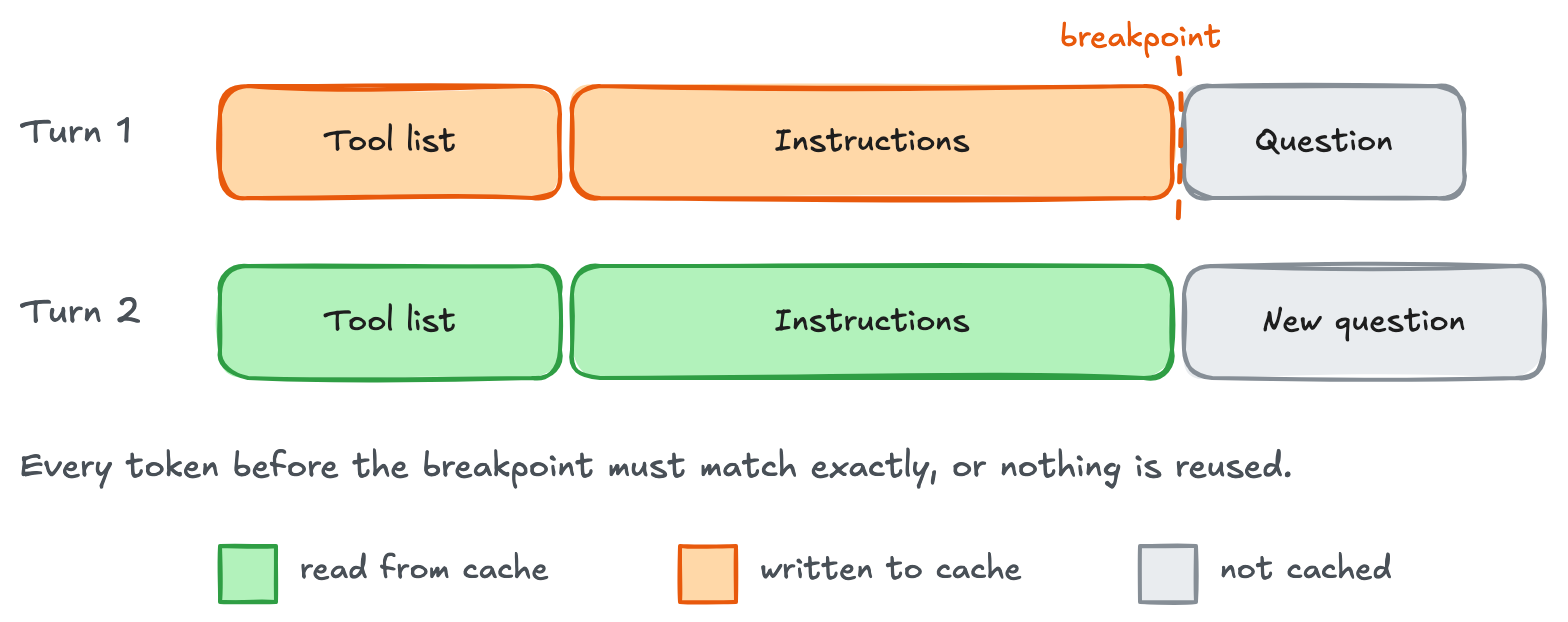
图 2:第 1 轮保存到断点为止的提示前缀,第 2 轮复用它,只为新问题支付全价
隐式还是显式,为什么两者都需要?
对于智能体工作负载,隐式缓存让 Bedrock 随着对话增长自行选择缓存内容。使用显式缓存,你可以标记共享内容(例如工具和指令),以便在多个会话之间以及启动辅助智能体时复用。你并不总是需要两种缓存形式,但将二者结合使用可以为你提供一个可复用的起点,同时由 Bedrock 自动管理不断增长的对话。
新会话也可以复用该共享起点,而每个对话则基于各自缓存的对话历史继续构建。在本文中,我们先从第一轮开始,然后展示如何将缓存内容延续到后续轮次、新工具以及跨子智能体使用。
Hello cached world
第一个收益是缓存提示词中的静态部分:即在各请求之间保持不变的指令和工具。这些示例使用你现有的 Amazon Bedrock 客户端、TOOLS 和 task。请将简写的 INSTRUCTIONS 字符串替换为真实的策略和示例。可复用的前缀必须达到 1,024 个 token 才符合条件。
缓存静态内容时,请使用显式模式:由你选择保存的前缀在哪里结束。
KEY = "support-agent:v7:gpt-6-astra"
INSTRUCTIONS = "Your full support policies and examples..."

# Rendered context: [provider context][TOOLS][INSTRUCTIONS] | [task]
# Cache starts at the beginning; the marker below chooses its end.
resp = client.responses.create(
    model="us.openai.gpt-6-astra",
    store=False,  # Response storage; prompt caching still works.
    include=["reasoning.encrypted_content"],
    prompt_cache_key=KEY,
    prompt_cache_options={"mode": "explicit", "ttl": "30m"},
    tools=TOOLS,  # Rendered before instructions; keep order stable.
    input=[
        {
            "role": "developer",
            "content": [{
                "type": "input_text",
                "text": INSTRUCTIONS,
                # Save through this whole block, including TOOLS.
                "prompt_cache_breakpoint": {"mode": "explicit"},
            }],
        },
        # User message is processed but not cached.
        {"role": "user", "content": task},
    ],
)
prompt_cache_key 告诉服务哪些请求应共享同一缓存。我们会在讲到在新会话中读取缓存时,再回来讨论如何使用它。在我们使用显式缓存的一次测试中,约 4,000 个 token 的工具与指令前缀在首次请求时写入了 4,120 个 token,并在后续请求中读取了这 4,120 个 token。task(或用户请求)位于缓存边界之后,因此不会触发对缓存的写入。
请记住,提示词缓存仅在你传入完全相同的文本时才有效。请确保智能体的指令和工具列表每次都按相同方式序列化。Model Context Protocol (MCP) 服务器及其他工具交付形式需要建立索引,以确保它们保持一致。请将任何会变化的内容(例如日期、用户名或请求 ID)放在已缓存的指令之后。
随着内容增长和变化(不同的工具和内容),使用隐式模式让服务跟随对话。在这里,第一个请求没有显式标记。其最新的符合条件消息是用户的任务,因此自动断点位于该任务之后,并覆盖工具、指令和任务。为清晰起见,下面的示例中显式展示了该模式,尽管隐式是默认值。设置 store=False 会将对话历史保留在你的应用程序中。它并不会禁用缓存。
def ask_with_implicit_cache(history):
    return client.responses.create(
        model="us.openai.gpt-6-astra",
        store=False,
        include=["reasoning.encrypted_content"],
        prompt_cache_key=KEY,
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
        tools=TOOLS,
        input=history,  # Everything gets cached
    )

history = [
    {"role": "developer", "content": INSTRUCTIONS},
    {"role": "user", "content": task},
]
# Automatic endpoint: the end of the user message.
resp = ask_with_implicit_cache(history)
当下一轮继续同一任务时,这很有用。不同的任务无法匹配经过旧任务的前缀,而隐式写入也不一定会为仅包含工具和指令的内容单独创建一个条目。当你需要让这个更短的共享前缀可跨任务复用时,请在那里使用显式标记。
当智能体既需要共享起点又需要不断增长的历史时,请同时使用两者。从下面代码示例中标记的 developer 块开始,并调用函数 ask_with_implicit_cache。请求级模式保持为隐式。块级标记会在指令之后添加一个显式保存点。服务还可以通过最新的符合条件消息进行保存。这样可以在对话增长的同时保持共享前缀可用。
history = [
    {
        "role": "developer",
        "content": [{
            "type": "input_text",
            "text": INSTRUCTIONS,
            "prompt_cache_breakpoint": {"mode": "explicit"},
        }],
    },
    {"role": "user", "content": task},
]
# Still implicit mode, now with an explicit startup save point in the history.
resp = ask_with_implicit_cache(history)
缓存对话历史和工具结果
模型按名称请求工具并提供其参数。你的应用程序必须执行它们。execute_function 是你构建的辅助程序,用于将这些请求路由到匹配的 Python 函数并返回其结果。以下循环使用此辅助程序运行每个请求的工具。它将模型的输出和所有工具结果追加到 history 列表中,然后再次发送该列表,直到模型返回最终答案。在隐式模式下,Amazon Bedrock 可以复用未更改的前缀,并缓存直到最后一个工具结果为止新增的内容。保持较早的消息和初始 TOOLS 不变。
import json

# Map tool names to their Python implementations.
TOOL_HANDLERS = {
    "get_owner": get_owner,
    # Register your other initial tools here.
}

def execute_function(name, arguments):
    """Run the requested tool and return its result."""
    handler = TOOL_HANDLERS.get(name)
    if handler is None:
        return {"error": f"Unknown tool: {name}"}
    return handler(**arguments)

while True:
    # Preserve all output items, including encrypted reasoning.
    history.extend(resp.output)
    calls = [x for x in resp.output if x.type == "function_call"]
    if not calls:
        break
    for call in calls:
        result = execute_function(call.name, json.loads(call.arguments))
        history.append({
            "type": "function_call_output",
            "call_id": call.call_id,
            "output": json.dumps(result),
        })
    # The last result in this group supplies the automatic endpoint.
    resp = ask_with_implicit_cache(history)
对于后续请求,追加一条新的用户消息并再次调用该辅助程序。保持较早的消息不变,以便其缓存的端点仍然可用。
滚动断点:每一轮都会读取其之前的所有内容
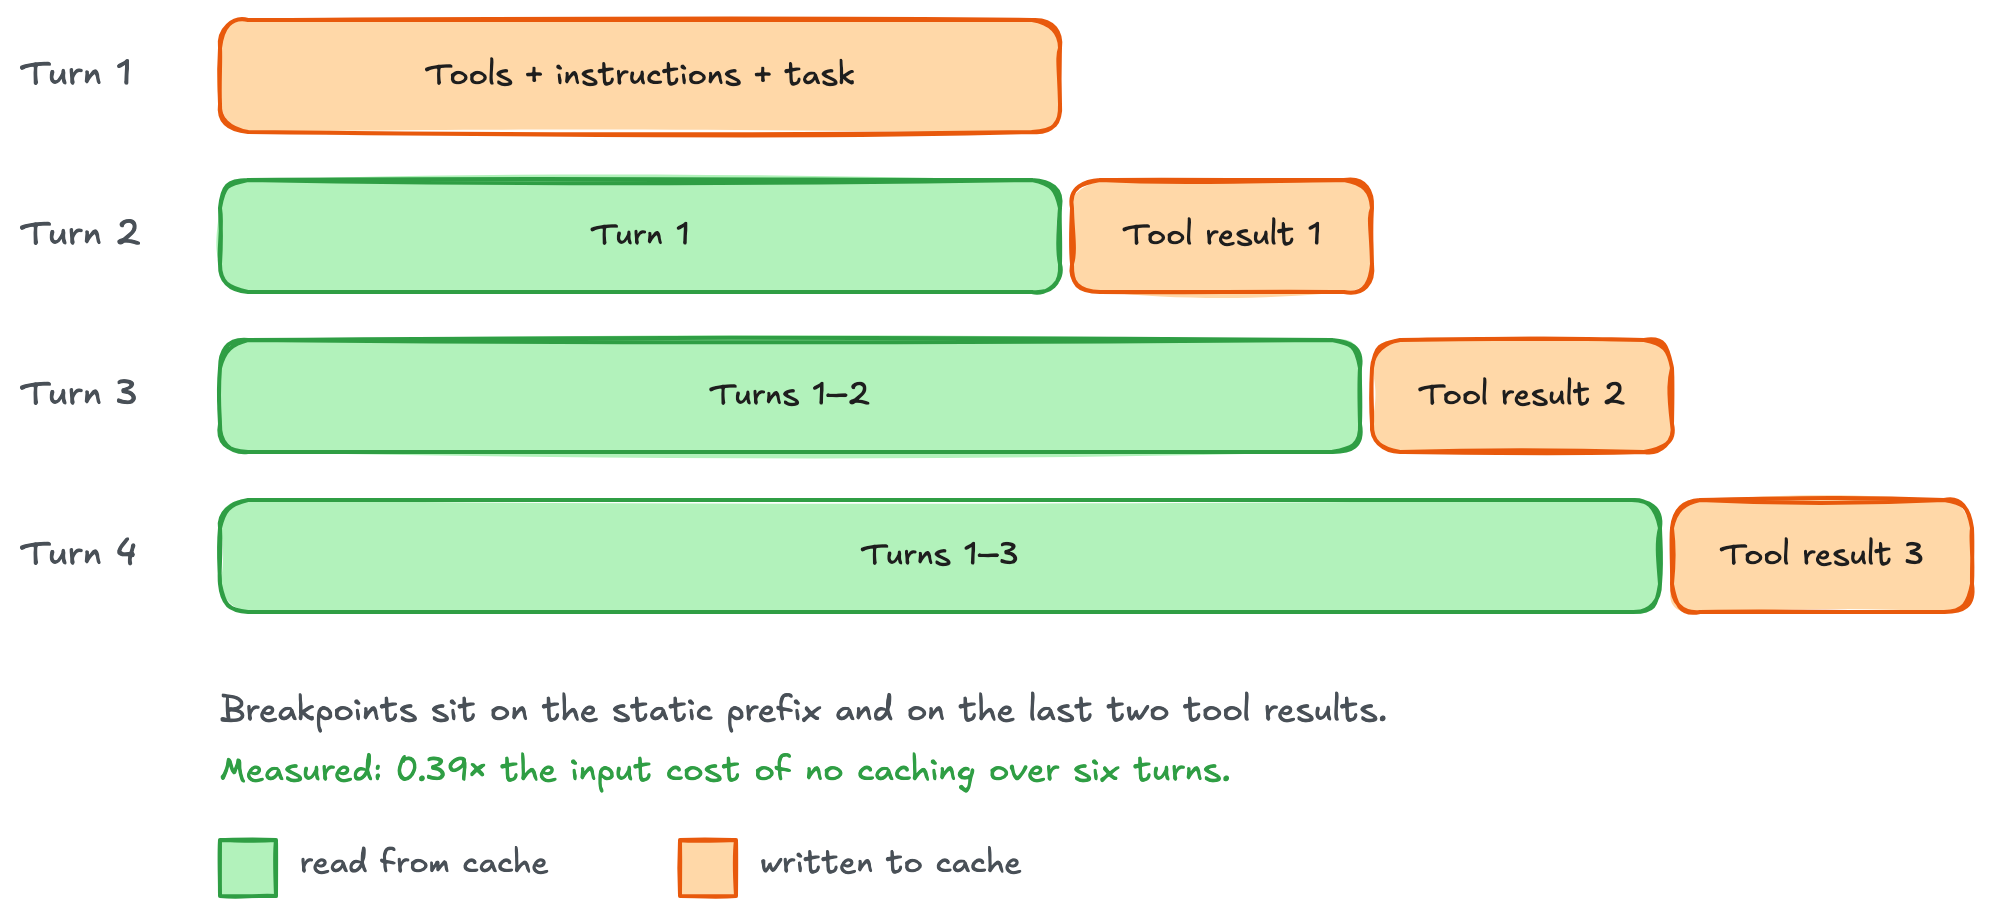
图 3:滚动断点,其中每一轮读取其之前的所有内容,并且只写入自己的工具结果
对于单独的仅显式运行,从组合的 Hello 缓存世界示例重新创建两条消息的历史记录。此循环将工具结果包装在 input_text 块中,并标记每批中的最终结果。较早的标记保留在 history 中。有关长对话,请参阅当前查找规则。
import json

while True:
    resp = client.responses.create(
        model="us.openai.gpt-6-astra", store=False,
        include=["reasoning.encrypted_content"],
        tools=TOOLS, prompt_cache_key=KEY, input=history,
        prompt_cache_options={"mode": "explicit", "ttl": "30m"},
    )
    d = resp.usage.input_tokens_details
    print("read", d.cached_tokens, "write", d.cache_write_tokens)
    history.extend(resp.output)  # Includes encrypted reasoning.
    calls = [x for x in resp.output if x.type == "function_call"]
    if not calls:
        break
    batch = []
    for call in calls:
        result = execute_function(call.name, json.loads(call.arguments))
        batch.append({
            "type": "function_call_output", "call_id": call.call_id,
            "output": [{"type": "input_text", "text": json.dumps(result)}],
        })
    # Add the newest boundary; retain every earlier marker.
    batch[-1]["output"][-1]["prompt_cache_breakpoint"] = {"mode": "explicit"}
    history.extend(batch)
GPT-6 Astra 在此六轮工作负载中并列最佳隐式结果:与不使用缓存运行相比,输入成本降低约 62%。显式滚动断点在同一模型上节省了约 61%。随着对话增长,两者都复用了更多历史记录。这些是工作负载结果。请测量你自己 agent 的节省情况。
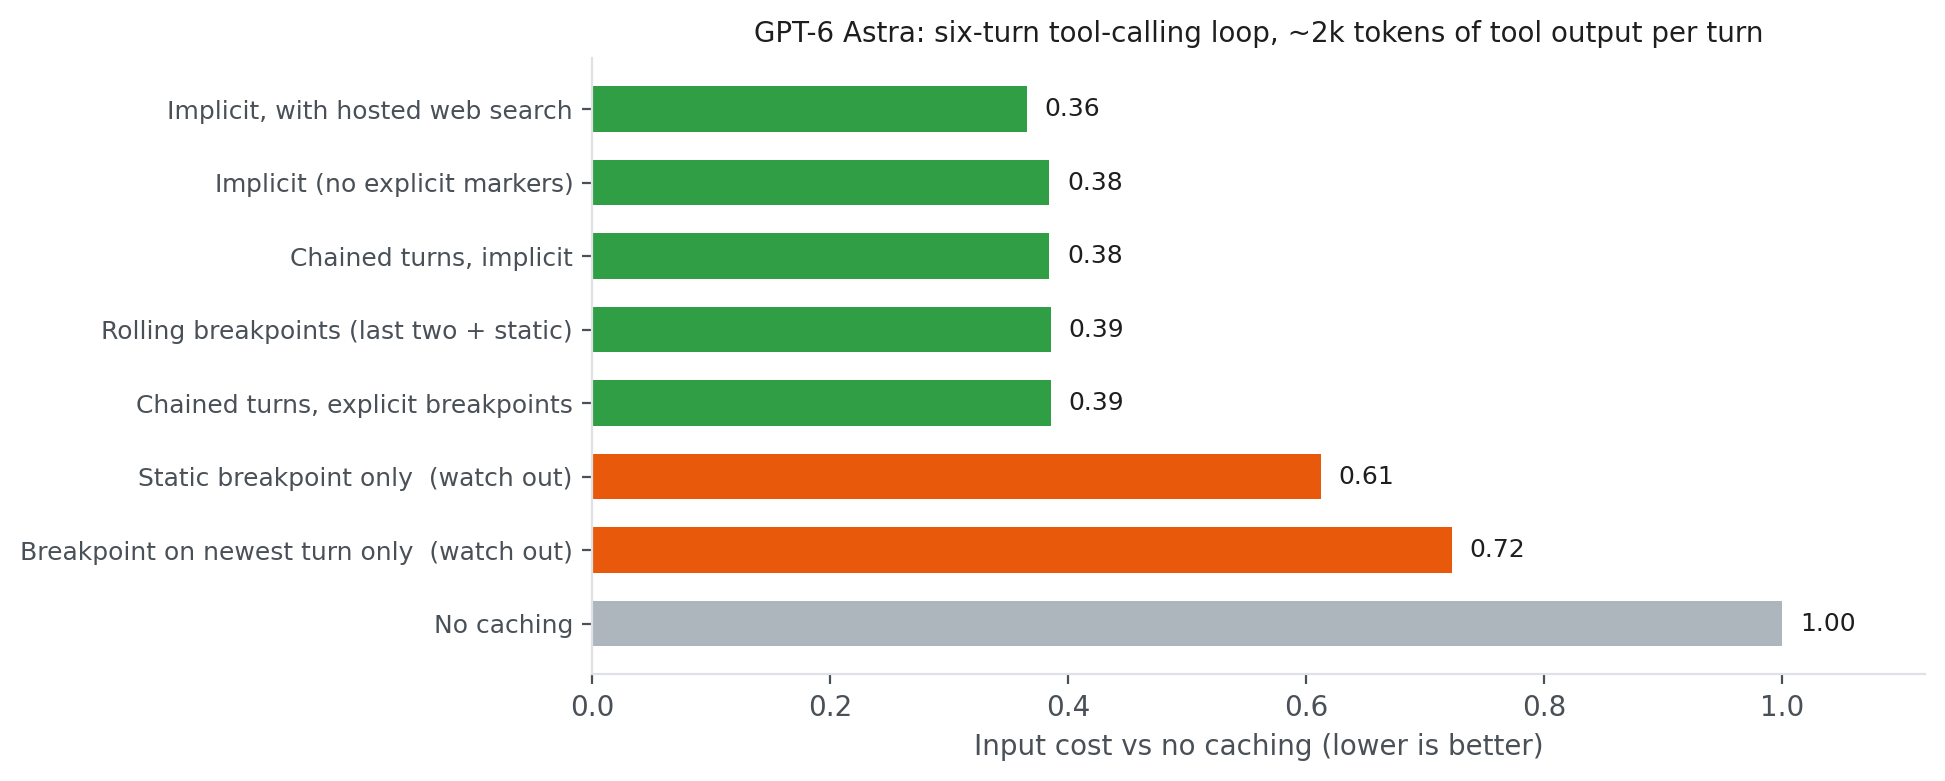
图 4:GPT-6 Astra 上每种缓存设置的输入成本(相对于无缓存)
注意:
- 仅显式模式下的静态断点 – 工具和指令被缓存,但增长的历史记录在每一轮都会重新处理(0.61)。此限制不适用于组合示例,该示例还通过符合条件的对话结尾节省成本。
- 移动单个断点可能会阻止缓存复用,并在仅显式模式下导致重复写入。请同时保留上一轮的断点。
- 仅通过变化的任务进行隐式写入 – 新任务可能共享工具和指令,但不共享先前保存的端点。如果不同任务需要复用该较短前缀,请在共享指令之后添加显式标记。
当工具发生变化时
有时 agent 的工具列表会变化,或者会添加新工具。保持初始列表稳定:添加、删除或重新排序定义可能会使缓存的前缀失效。选择适合工具可用方式的方案。
当已知工具在 agent 流程的不同步骤中被调用时:发送相同的已排序 TOOLS,并使用 allowed_tools 限制模型可以调用的内容。使用 allowed_tools 时,"mode": "auto" 让模型决定是否调用允许的工具,而 "mode": "required" 要求至少调用一个允许的工具。将此作为 tool_choice 传入。该限制不会更改缓存的目录:
tool_choice={"type": "allowed_tools", "mode": "auto",
             "tools": [{"type": "function", "name": "get_owner"}]}
会话期间的新工具。 Amazon Bedrock Runtime 和 Amazon Bedrock Mantle 端点都接受一种名为 additional_tools 的输入项类型,适用于 GPT-6 Astra、GPT-6.1 Sol 和 GPT-5.6 Luna。有关按 AWS 区域划分的模型可用性,请参阅Amazon Bedrock 中按 AWS 区域支持的模型。在辅助函数 execute_function 中注册新工具 get_due_date,然后将其 schema 追加到 agent 循环中已完成的历史记录。保持初始 TOOLS 不变:
TOOL_HANDLERS["get_due_date"] = get_due_date
NEW_TOOL = {
    "type": "function", "name": "get_due_date",
    "description": "Return the due date for a support case.",
    "strict": True,
    "parameters": {
        "type": "object",
        "properties": {"case_id": {"type": "string"}},
        "required": ["case_id"], "additionalProperties": False,
    },
}
history.append({
    "type": "additional_tools", "role": "developer",
    "tools": [NEW_TOOL],
})
history.append({
    "role": "user", "content": "Find the due date for case C-123.",
})
# Implicit mode saves through this new user message, including NEW_TOOL.
resp = ask_with_implicit_cache(history)
d = resp.usage.input_tokens_details
print("old prefix read", d.cached_tokens, "new write", d.cache_write_tokens)

# Example output:
# old prefix read 2048 new write 256
会话中途出现新工具
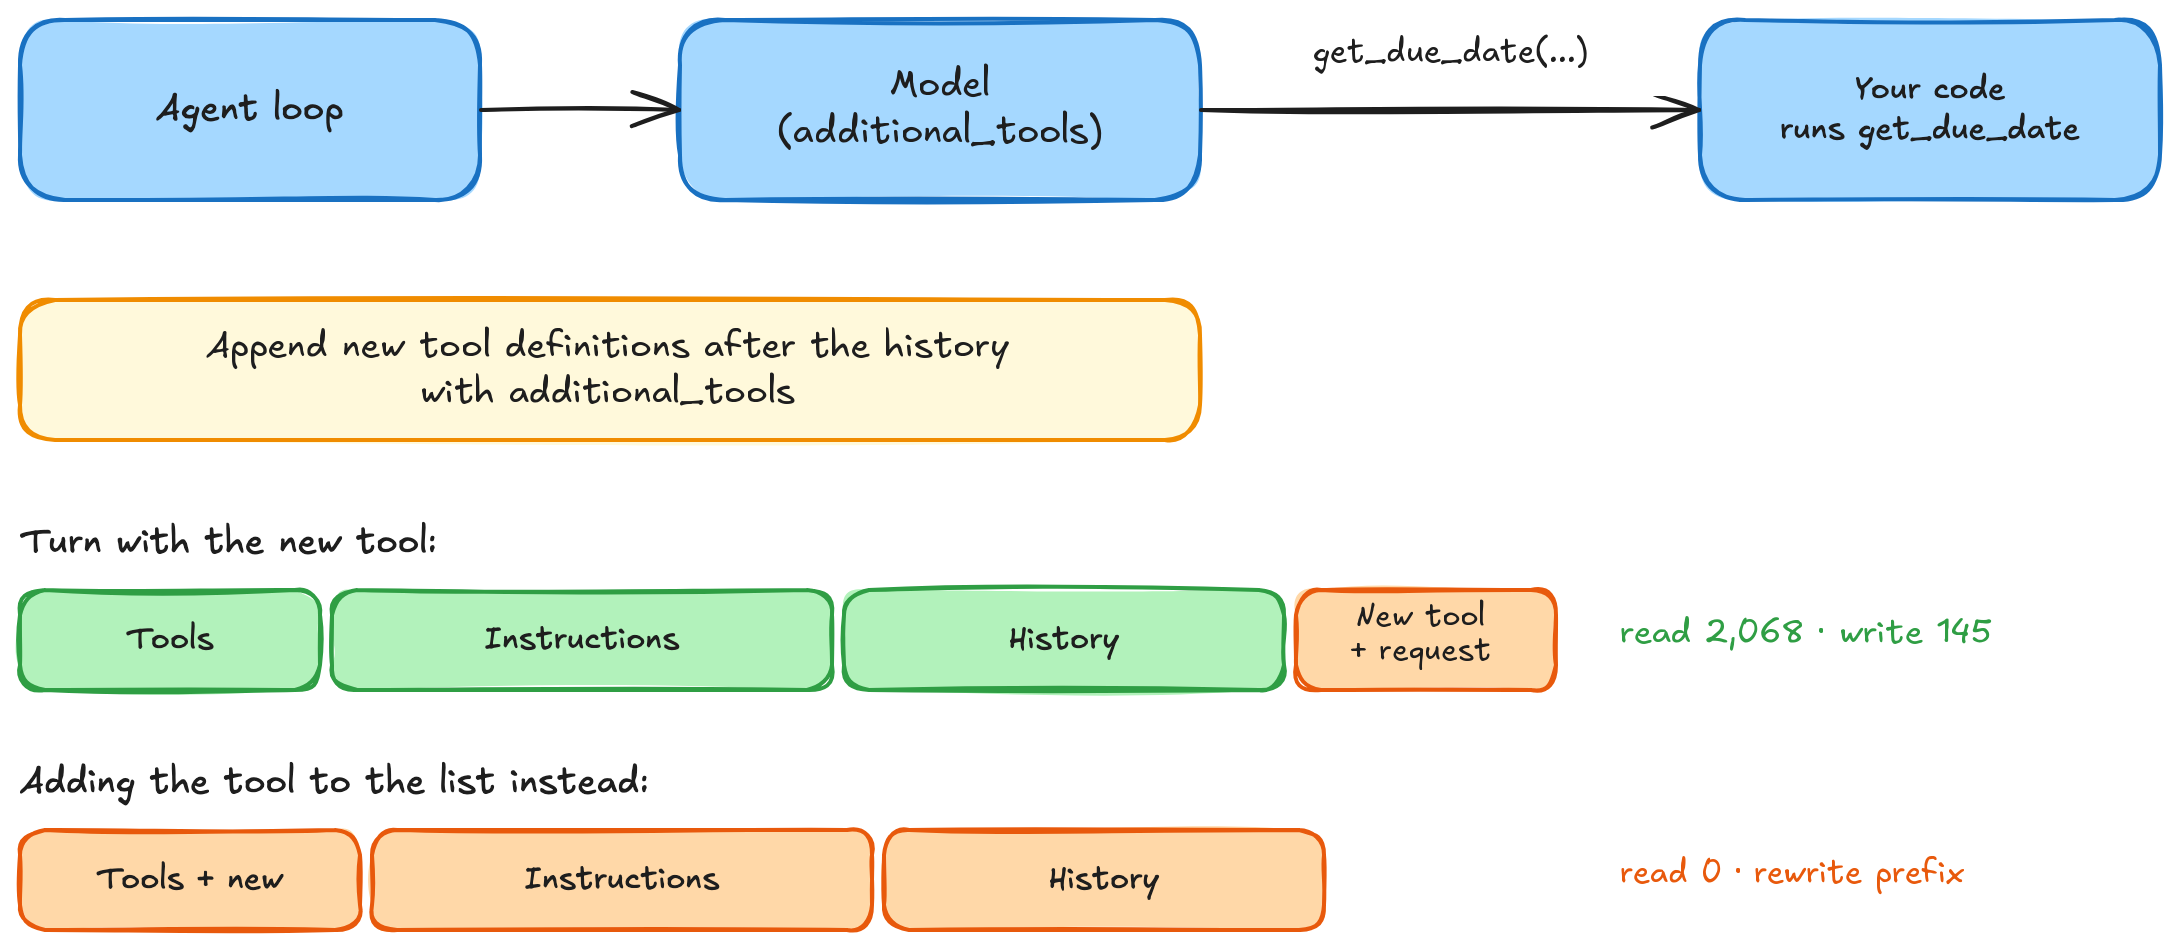
图 5:追加一个工具后,先前的前缀仍可复用,示例计数来自 Amazon Bedrock Runtime 上的 GPT-6 Astra
用新的响应继续工具执行循环。该循环会把模型的输出追加到 history,运行任何被请求的工具,并追加它们的结果。在后续请求中保留 additional_tools 项,以便新工具保持可用。在隐式模式下,Amazon Bedrock 可以缓存到新的用户消息为止,包括位于其前面的工具定义。在仅显式模式下,保留先前的断点,并在该用户消息中的一个 input_text 块上添加一个断点。additional_tools 项本身不能持有断点。
不同角色,不同目录。 当不同的 agent 角色需要不同的工具时,在每个会话开始时选择一个稳定的工具配置文件,例如支持或计费。每个配置文件都有自己的缓存前缀。标记共享指令,以便之后使用该配置文件的任务可以复用它们,然后随着对话增长使用任一模式。
缓存的工具配置文件
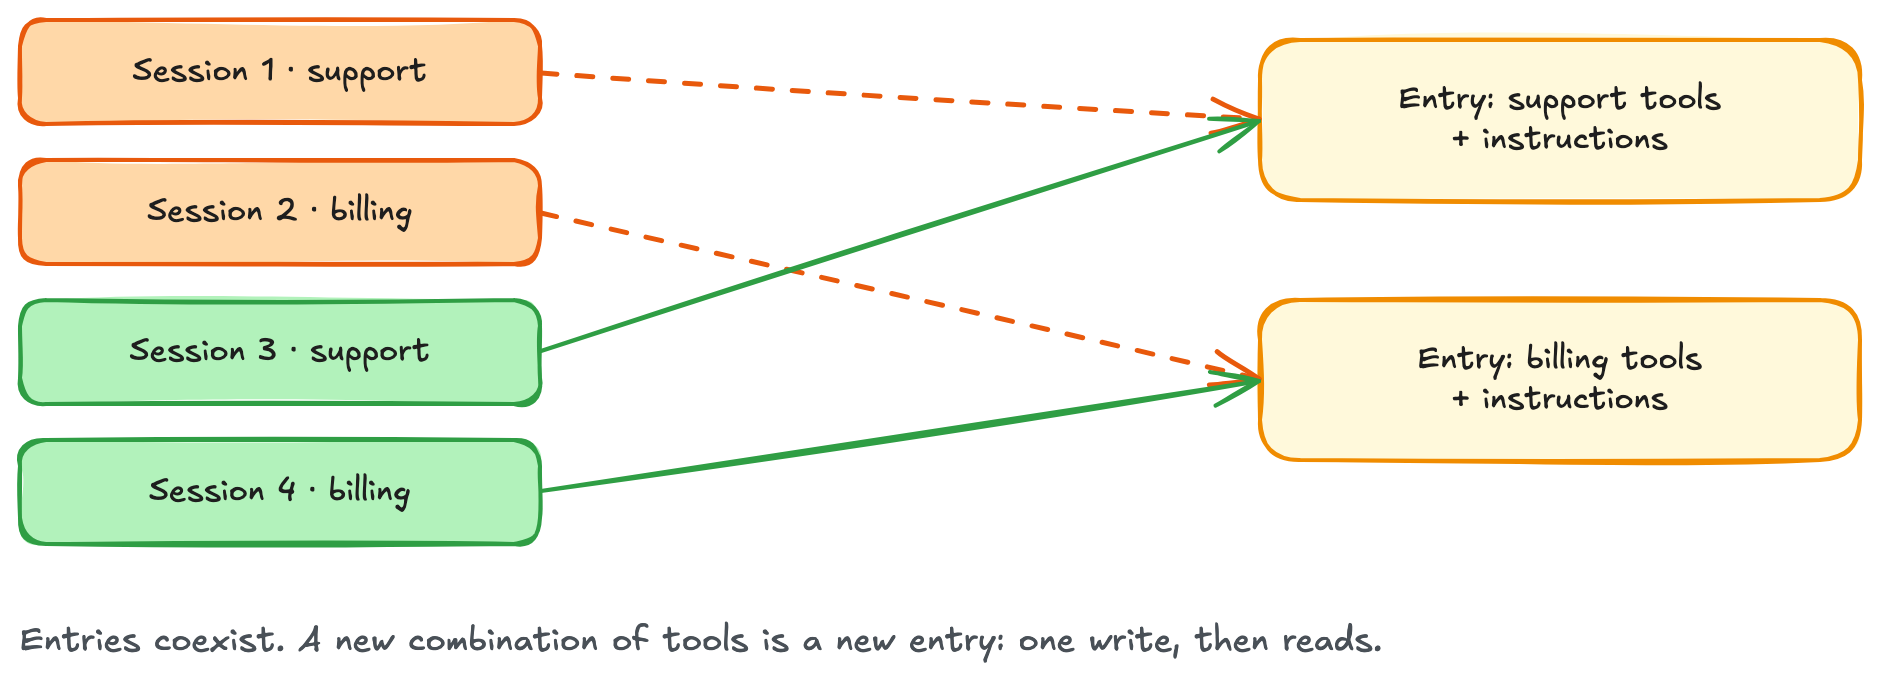
图 6:每个工具配置文件都有自己的缓存前缀,可由匹配的会话复用
子代理与旁路调用
委派不应让每个助手都重读相同的背景。共享前缀,然后在末尾添加每个助手的任务。请注意,当你将缓存与 AI agent 一起使用时,工具和系统提示可能会被泄露或利用。建立负责任的 AI 实践,并将你的提示缓存实现纳入该治理的一部分。
预热一次,然后扇出。 先发送一个普通请求,并等待其完成后再启动助手。在每个请求中显式标记共享上下文,即使模式是隐式的:
shared = {"role": "developer", "content": [{
    "type": "input_text", "text": INSTRUCTIONS,
    "prompt_cache_breakpoint": {"mode": "explicit"},
}]}
warm = client.responses.create(
    model="us.openai.gpt-6-astra", store=False,
    tools=TOOLS, prompt_cache_key=KEY,
    prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    max_output_tokens=16,
    input=[shared, {"role": "user", "content": "Reply READY."}],
)
d = warm.usage.input_tokens_details
if not (d.cache_write_tokens or d.cached_tokens):
    raise RuntimeError("Shared prefix was not cached.")
from concurrent.futures import ThreadPoolExecutor

# helper_tasks contains the task text for each helper.
helper_inputs = [
    [shared, {"role": "user", "content": task}]
    for task in helper_tasks
]
with ThreadPoolExecutor(max_workers=4) as pool:
    helpers = list(pool.map(ask_with_implicit_cache, helper_inputs))
助手使用与预热相同的 TOOLS、模型和 KEY。在输出上限处结束的预热仍可填充缓存。用量检查会在助手启动前确认缓存活动。
子代理:预热共享前缀一次,然后扇出
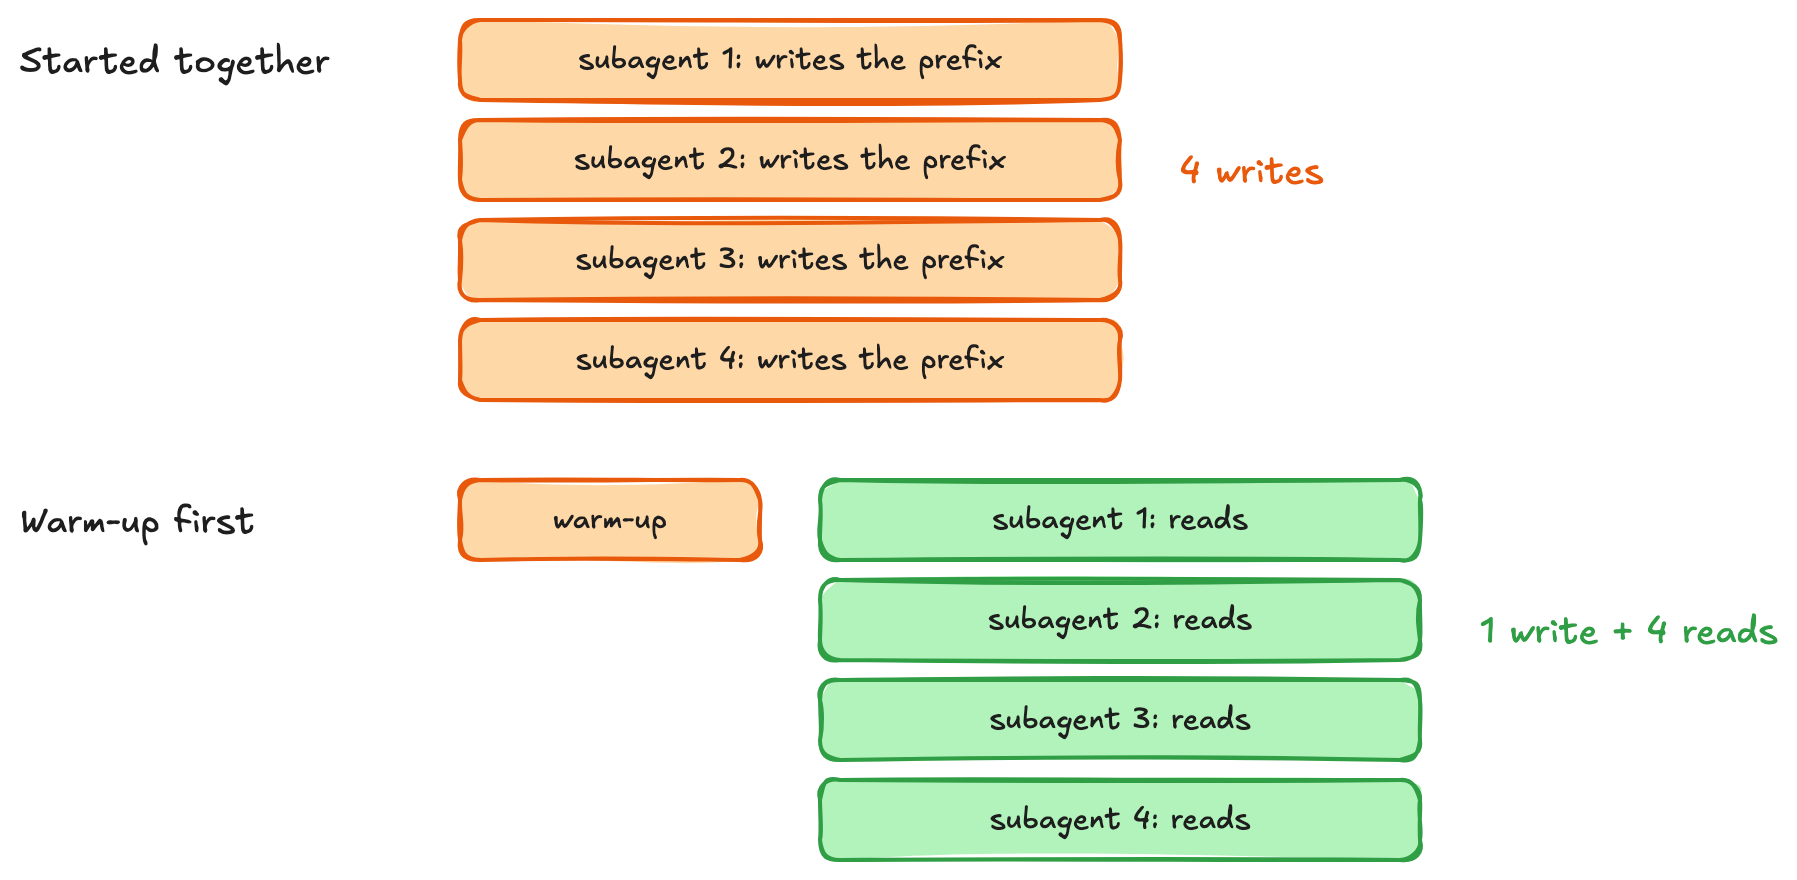
图 7:在启动助手前预热共享前缀,然后每个助手添加自己的任务
让旁路调用具有相同的开头。 agent 循环通过追加每个 resp.output 及其匹配的工具结果(包括加密推理)来构建 history。父级完成后,复制该完整列表给摘要器或评判器。同一助手保持工具、模型和密钥不变:
from copy import deepcopy

# history is the completed history built by the agent loop above.
# Copy it so the helper can add instructions without changing the parent.
helper_history = deepcopy(history)
helper_history.append({
    "role": "developer",
    "content": "Summarize this conversation in one sentence. Do not call tools.",
})
summary = ask_with_implicit_cache(helper_history)
d = summary.usage.input_tokens_details
print("history read", d.cached_tokens, "write", d.cache_write_tokens)
print(summary.output_text)

# Example output (assumed values and conversation):
# history read 4096 write 32
# Case C-123 is due on October 31, 2026.
助手可以复用 history 的缓存部分,但追加的开发者消息不会自动将缓存扩展到包含摘要指令。如果后续请求复用相同的历史和指令,请将指令放在带有 prompt_cache_breakpoint 的 input_text 块中。对于一次性摘要,不需要额外的标记。
暂停、重启与缓存键
暂停。 缓存前缀的最短生存时间(TTL)为 30 分钟,成功复用会刷新它,并且可能保持更长时间。如果会话很快恢复,普通预热可以在前缀过期前刷新它。将该请求的成本与让缓存过期进行比较。有关 TTL 规则,请参阅 Amazon Bedrock 文档。
新会话。 对于旨在共享前缀的请求,保持 prompt_cache_key 稳定。会话特定的键会隔离会话,即使它们的提示匹配。在以下示例中,切换到共享键让会话复用了前缀。
新会话仅在共享键时复用缓存
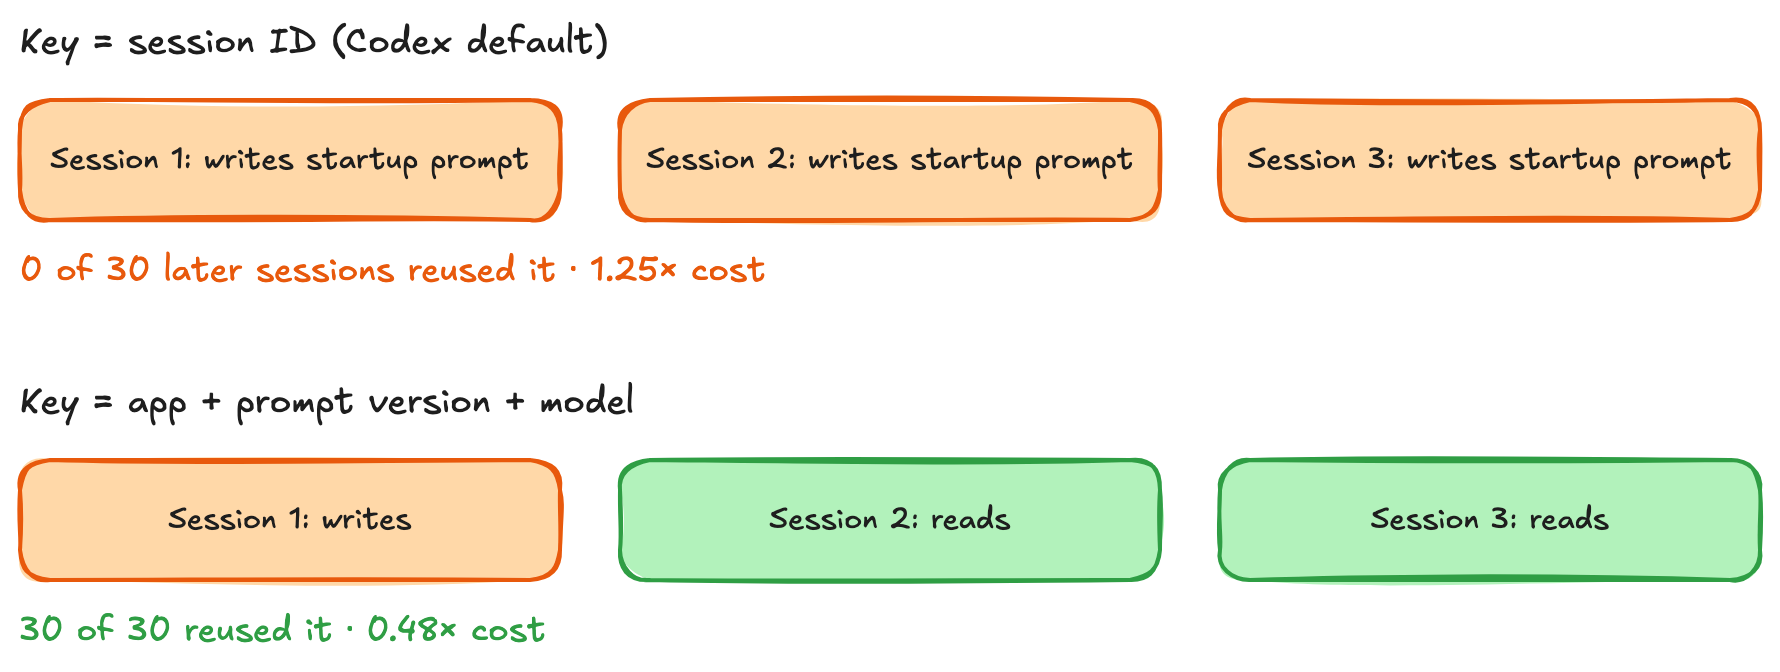
图 8:会话特定的键分隔缓存条目,共享键让匹配的会话复用它们
复用现有缓存内容需要相同的模型、AWS 账户和区域,以及可用的匹配前缀。以下示例将显式启动标记与隐式模式结合使用。每个会话都以相同的指令和各自的任务开始。两者使用相同的计算键:
import hashlib

def cache_key(app, model, prompt_version, instructions):
    digest = hashlib.sha256(instructions.encode()).hexdigest()[:12]
    return f"{app}:{prompt_version}:{model}:{digest}"

KEY = cache_key("support-agent", "us.openai.gpt-6-astra", "v7", INSTRUCTIONS)
prefix = {"role": "developer", "content": [{
    "type": "input_text", "text": INSTRUCTIONS,
    "prompt_cache_breakpoint": {"mode": "explicit"},
}]}
for label, question in [
    ("session A", "Explain the refund policy without calling tools."),
    ("session B", "Explain the escalation policy without calling tools."),
]:
    # A fresh conversation for each session; the startup prefix matches.
    session_history = [prefix, {"role": "user", "content": question}]
    result = ask_with_implicit_cache(session_history)
    d = result.usage.input_tokens_details
    print(label, "read", d.cached_tokens, "write", d.cache_write_tokens)
在冷启动时,会话 1 写入共享前缀。会话 2 即使任务不同也能读取它。每个任务也可以被隐式缓存。检查使用计数器:匹配的键和标记使复用成为可能,但缓存条目仍必须可用。
提示缓存能带来什么
成本。对于一个由 GPT-6 Astra 驱动、拥有 8,000 token 启动前缀、六轮对话每轮增加 2,000 token 的智能体,一次性静态缓存将成本降至 $0.50,而滚动断点将建模输入成本降低了 64%:从每会话 $0.87 降至 $0.32。
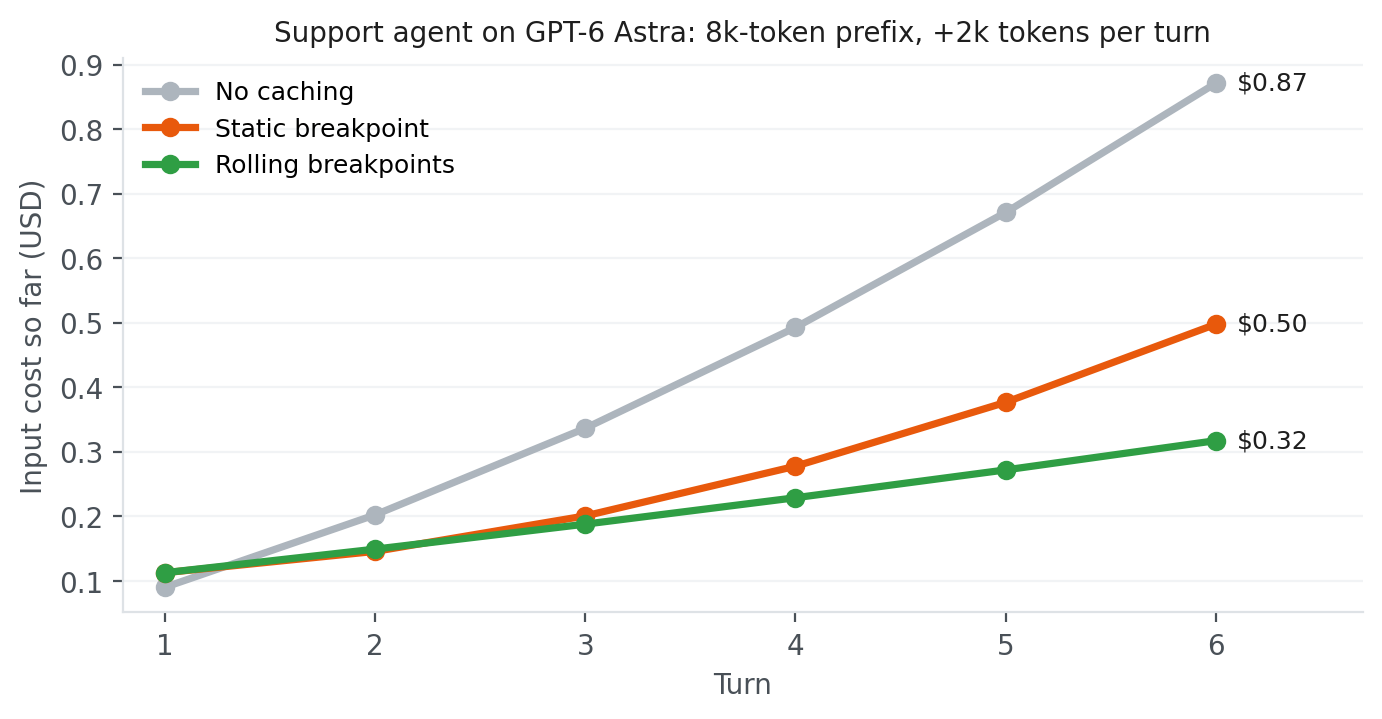
图 9:支持智能体示例的每会话累计输入成本,使用 GPT-6 Astra 的 Amazon Bedrock 按需价格
如何判断缓存正在生效
从响应使用情况开始。cached_tokens 报告从缓存读取的输入,cache_write_tokens 报告写入缓存的输入。随着对话增长,检查后续轮次是否复用较早的历史记录,以及新的写入是否反映了正在添加的内容。
对于 Amazon Bedrock Runtime 端点上的生产监控,请使用 Amazon CloudWatch 中的 CacheReadInputTokenCount 和 CacheWriteInputTokenCount 指标。当需要单个请求记录时,启用模型调用日志记录,然后使用 Amazon CloudWatch Logs Insights 查询它们。对于 Amazon Bedrock Mantle 端点,请在应用程序日志中记录响应使用字段。其 Amazon CloudWatch 命名空间目前没有单独的缓存计数器。
要检查成本,请将 AWS Cost Explorer 筛选为 Amazon Bedrock,并按 Usage type 分组。缓存读取、缓存写入和未缓存输入会按模型分别显示为单独的条目。在计算它们在输入成本中的占比时,请排除输出 token 条目。
一份简短清单
- 保持可复用前缀稳定。 将共享工具和指令放在最前面,然后追加对话历史和新轮次。更改时间戳、消息或工具定义会阻止该更改之后的复用。如果较短的前缀拥有自己保存的端点,它仍然可以被复用。
- 围绕你希望复用的内容选择边界。 对不断增长的历史记录使用隐式缓存,对共享前缀使用显式标记,或两者兼用。仅显式模式可避免写入一次性后缀。在扩展仅显式对话时,保留较早的标记,以便后续请求能够找到已保存的前缀。
- 保持初始工具目录不变。 使用
allowed_tools限制哪些工具可被调用。使用additional_tools追加已知定义,或通过带命名空间的客户端tool_search发现它们。当不同智能体角色需要不同目录时,选择稳定的工具配置文件。 - 检查前缀大小和生命周期。 可缓存前缀必须至少包含 1,024 个 token。缓存前缀在其最近一次写入或成功复用后至少 30 分钟内仍可被复用。
- 在启动辅助程序之前预热共享内容。 在预热请求和辅助请求中都标记共享前缀,包括使用隐式模式时。在启动并行调用之前完成预热请求。
- 在每个共享组内保持缓存键稳定。 旨在复用某个前缀的请求必须使用相同的键。不同的键可以使不同客户或用户之间的缓存核算保持独立。
- 衡量整个工作流程中的节省。 缓存写入的成本是正常输入费率的 1.25 倍。读取价格取决于模型。在开发过程中使用响应用量、在生产环境中使用监控和账单数据,将写入成本与读取节省一并跟踪。
2 月 3 日醒来
比尔·默里只有在不再重复同样的错误、并开始把从一天中学到的东西带到下一天时,才逃离了《土拨鼠之日》。智能体也以类似的方式(尽管没那么浪漫)达到这一点:保持提示开头逐字节稳定,并随着历史增长使用自动或显式缓存边界。
在这篇文章中,我们介绍了如何缓存共享工具和指令、在智能体轮次之间扩展缓存,以及在添加工具、启动辅助程序或开始新会话时保持复用。保持共享前缀稳定,并随着工作流程推进追加新信息。对不断增长的对话使用隐式缓存,对共享内容使用显式断点。当两者都需要时可将它们结合使用,或者当变化的后缀不太可能被复用时选择仅显式模式。比较缓存读取、写入、总输入成本和延迟,找到最适合你的智能体的方案。要应用这些模式,请遵循 Amazon Bedrock 针对 OpenAI 模型的提示缓存文档,并查看 按 AWS 区域和端点划分的模型可用性。从一个工作流程开始,并随着对话增长衡量节省。
关于作者

Claudio Mazzoni
Claudio 是 Amazon Bedrock GTM 团队的高级专家解决方案架构师。Claudio 擅长引导客户完成其生成式 AI 之旅。工作之余,Claudio 喜欢与家人共度时光,并在自家花园里劳作。
来源:AWS Machine Learning Blog · aws.amazon.com